Appearance
AI 应用本地部署持续迭代
Chris Books
带着实际问题,指定一本或多本书,从书中的框架、方法与适用条件中寻找解法,让阅读成为实践指南,并沿引用核对依据。
查看 GitHub问题分析 · 方法对照 · 有依据的实践思路
它解决什么问题
读过书、记住观点,遇到自己的问题却仍不知道怎么用。把具体情境与问题交给选定的一本或多本书,查找可借鉴的框架、方法、适用条件与边界,帮助把书面知识转成可以尝试和验证的实践思路。
适合谁使用
在学习规划、团队协作、产品验证等实际问题中,希望借助指定书籍分析处境、比较方法并找到下一步行动思路的人。
它如何工作
导入与解析
批量导入 PDF,按文件哈希去重,每本书独立处理;长书分卷并保留整本页码偏移。解析使用 MinerU 云 API,原文件和解析结果归档到本地,扫描质量取决于原件与解析服务。
- 输入
- 一本或多本 PDF 与自行配置的 MinerU 服务
- 产出
- 原始 PDF、Markdown、JSON、图片与解析 ZIP
让书中的方法,成为解决实际问题的指南
读过一本书,记下了不少观点,遇到自己的问题时却不知道该用哪一条、从哪里开始。Chris Books 希望补上从理解知识到运用知识的这一步:带着自己的实际问题,指定一本或多本书,借助书中的框架和方法分析处境,形成下一步可以尝试、验证的实践思路。
你可以围绕一本书深入追问,也可以把几本书放在一起,比较不同方法的共识、分歧和适用条件。建议保留来源引用,方便核对哪些是书中观点,哪些是结合问题形成的推导,再判断是否适合自己的情境。
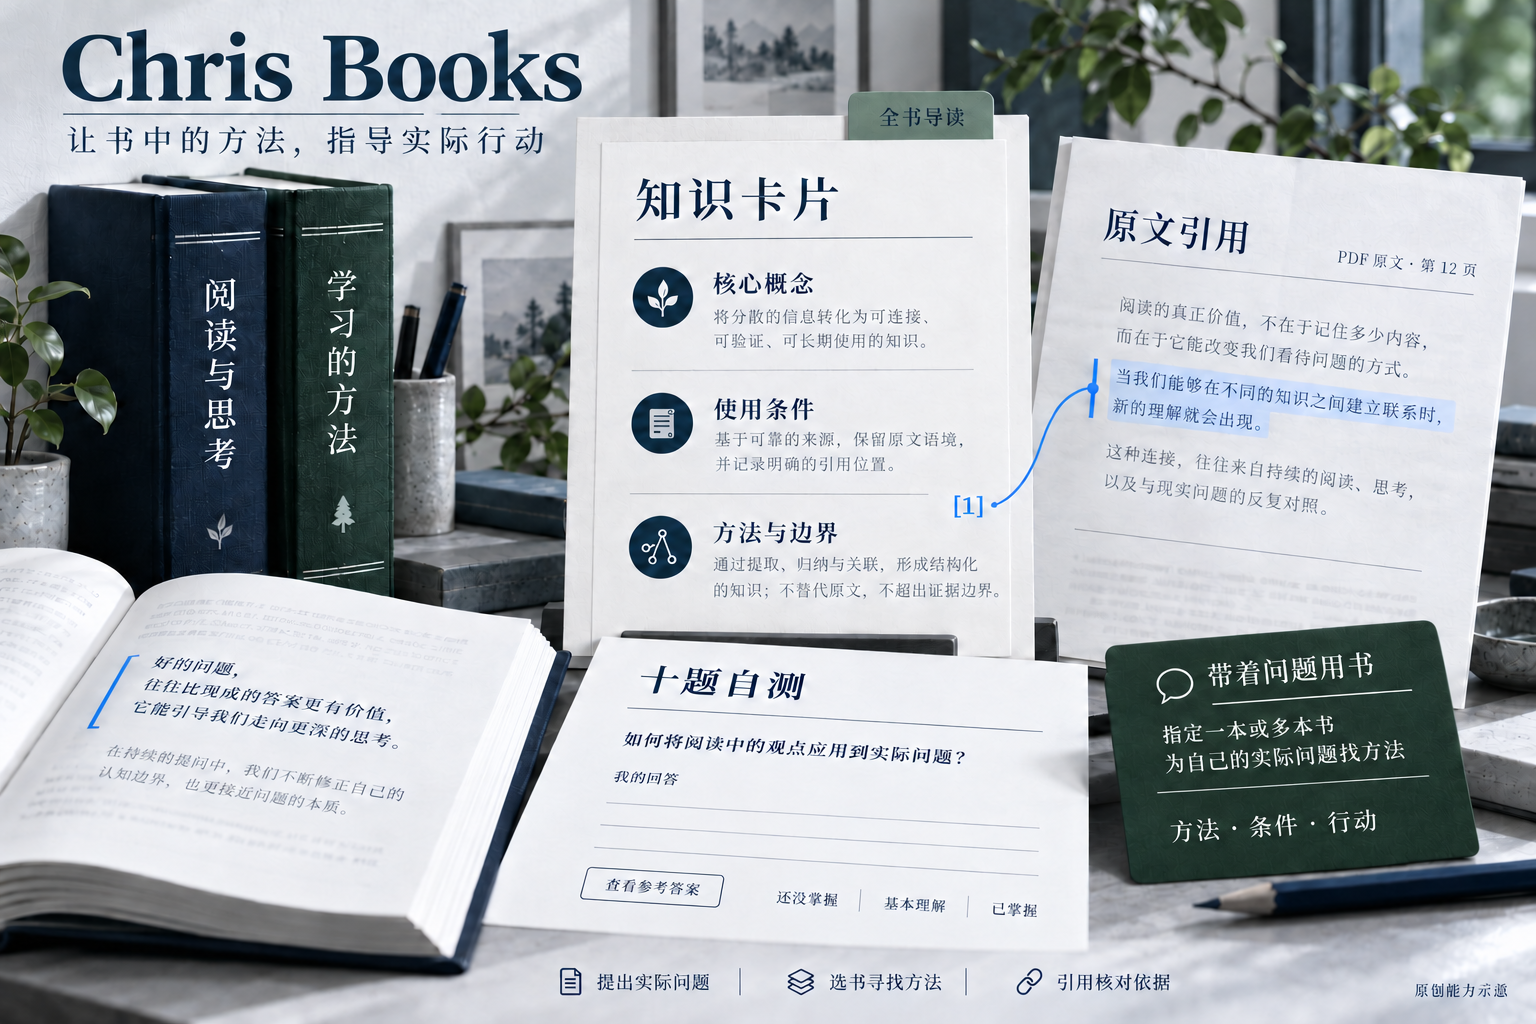
本地书库、PDF 解析、全书导读、知识卡片与自测为这条实践路径提供材料。顶部配图为原创能力示意,图中书名、正文、题目和页码均为虚构演示。
从“这本书讲什么”到“我的问题该怎么做”
先说明自己的处境、想达到的目标、已经尝试的办法和现实限制,再选择相关的一本或多本书。问题越具体,越容易判断书中的方法是否适用;后续可以围绕同一个问题继续追问和核对。
下面是可以使用的提问方式,用于说明应用场景,不是已完成的案例或效果承诺:
| 自己遇到的问题 | 可以怎样带着问题用书 |
|---|---|
| 学习投入不少,过几天却想不起来 | 选学习方法类书籍,结合当前练习方式,查找相关方法的适用条件,讨论下一轮可以怎样尝试并检查效果 |
| 团队反复开会,同一个问题仍没有推进 | 选沟通或协作类书籍,对照自己的会议情境,寻找分析框架、待确认的信息与可尝试的改进方法 |
| 准备做一个产品,拿不准先验证什么 | 选产品或用户研究类书籍,比较不同验证方法,结合时间与资源限制,讨论可以先验证的假设与方法边界 |
也可以直接这样提问:
我的实际问题是……,目标是……,已经尝试过……,目前的限制是……。请依据我选定的这些书,找出相关框架和方法,说明适用条件、不同观点的差异,以及哪些可以用于我的情境。请给出有原文依据的实践思路,指出需要先确认的信息和可以尝试验证的第一步;书中没有依据的地方请明确说明。
由此得到的实践思路,需要结合自己的条件尝试、观察和调整。系统依据实际检索到的原文回答,证据不足时会说明;它不会因为选了几本书就掌握现实问题的全部背景,也不会替你执行行动或验证成效。
PDF 解析与原文归档
书库支持一次上传多个 PDF,按 SHA-256 文件哈希去重,每本书独立处理,一本失败不阻断其他书。解析调用自行配置的 MinerU 云 API,保存原始 PDF、Markdown、JSON、图片及 ZIP;扫描识别效果取决于原文件和解析服务。
长书默认按不超过 200 页、190MB 分卷,保留整本 PDF 和页码偏移。书籍详情展示识别页数、原文片段、字符数与 Markdown 份数,方便先核对解析成果。尚未配置生成或向量模型时,也可以浏览、下载已解析原文。
全书导读、知识卡片与自测练习
生成学习包时,系统按章节整理概念、框架、原则与方法,保存定义、适用条件、步骤、边界和证据;同时整理全书导读、术语表、决策速查与十题自测。推导与作者原意分开标注,学习材料用于辅助阅读,仍需回到原文确认关键理解。
阅读工作台提供四个区域:
| 区域 | 可以做什么 |
|---|---|
| 全书导读 | 先看核心观点,再从章节地图进入逐章材料,点击观点引用核对依据 |
| 知识卡片 | 按关键词、类型和章节筛选,查看概念、使用条件、方法与边界 |
| 自测练习 | 逐题回忆,可先写下回答,再展开参考答案并手动自评 |
| 原文阅读 | 使用目录、关键词搜索与 PDF / Markdown 对照阅读,也可切换为单独阅读模式 |
自测不自动评分,展开答案不会增加完成数;回答草稿与自评仅保留在当前书籍页面内存中,刷新或离开后重置。阅读已保存的材料和切换区域不会自动调用生成或嵌入模型。
在选定书籍内提问,沿引用核对答案
问答可以选择一本或多本已建立索引的书,不必先生成学习包。检索结合中文分词、SQLite FTS5 与向量索引,在固定范围内寻找原文依据,再组织回答和引用。跨书比较仍需检查原文,证据不足或比较超出处理预算时会说明缺口。
会话固定创建时的书籍和版本。重新解析、蒸馏或变更模型后,需要创建新会话;嵌入模型变化需要重建索引,已有会话不会静默迁移。
点击引用会打开原文证据,再进入该解析版本的阅读上下文。PDF 页码采用原文件的物理页码;只有可靠版面坐标才高亮,Markdown 只有与带页码的结构化原文唯一匹配时才建立定位。不能可靠匹配时会提示,并保留完整原文与 PDF。历史引用保留历史版本;删除书籍后,原会话文字仍保留,但被删原文不可再读取。
任务恢复与资料导出
解析与学习包任务保存阶段检查点。临时超时、限流或服务故障时,任务退避等待后恢复,等待期间其他书籍仍可处理,成功步骤可以复用。连续八轮无新进展会暂停等待处理;鉴权和配置错误立即暂停。云提交结果不明确时不盲目重提,需要先核对远端任务再明确发起解析。
重新解析或蒸馏创建新版本,完成后才切换。单书整包与全库备份以 ZIP 下载,保存资料及版本、引用关系。全库恢复需要空书库,恢复后的未完成任务应检查后手动重试;服务密钥配置不进入书库备份。
本地部署与使用边界
项目使用 Python / FastAPI + React / TypeScript,结合 MinerU、LlamaIndex、SQLite FTS5、sqlite-vec、PDF.js。快速启动需要 Python 3.12、Node.js 22+ 与 pnpm,在项目中执行 ./scripts/setup.sh 和 ./scripts/start.sh,然后按项目 README 配置服务。
本地书库浏览不需要密钥;PDF 解析、知识蒸馏和问答会调用对应云服务。因此资料保存在本地,并不意味着处理全程离线。供应商、API 地址和密钥由使用者自行配置。
项目原创代码采用 PolyForm Noncommercial 1.0.0,属于源码可用项目;商业使用须按许可证取得书面授权,已允许用途除外。具体范围以项目完整许可证为准,书籍与第三方组件另遵循各自权利和条款。
本次收录核对了项目最新 README、实现与验收文档,未调用真实解析或模型服务;合成测试不能证明真实书籍的知识覆盖率或回答准确率。使用方式、配置说明与更新记录见 Chris Books 项目仓库。