Appearance
Q111 · AI Agent 长期记忆的主流数据库有哪些?
做一个长期服务用户的客服 Agent:用户 U7 说过“以后请用中文回答”,还曾在上个月排查过一次网络抖动。今天他重新来问“网络又不稳了”。系统要先准确取出 U7 的语言偏好,也可能找出 U7 以前那次相似故障的处理经过。前者像按姓名和字段查档案,后者像在许多记录里找意思相近的笔记。这两种读法决定存储技术怎么选。
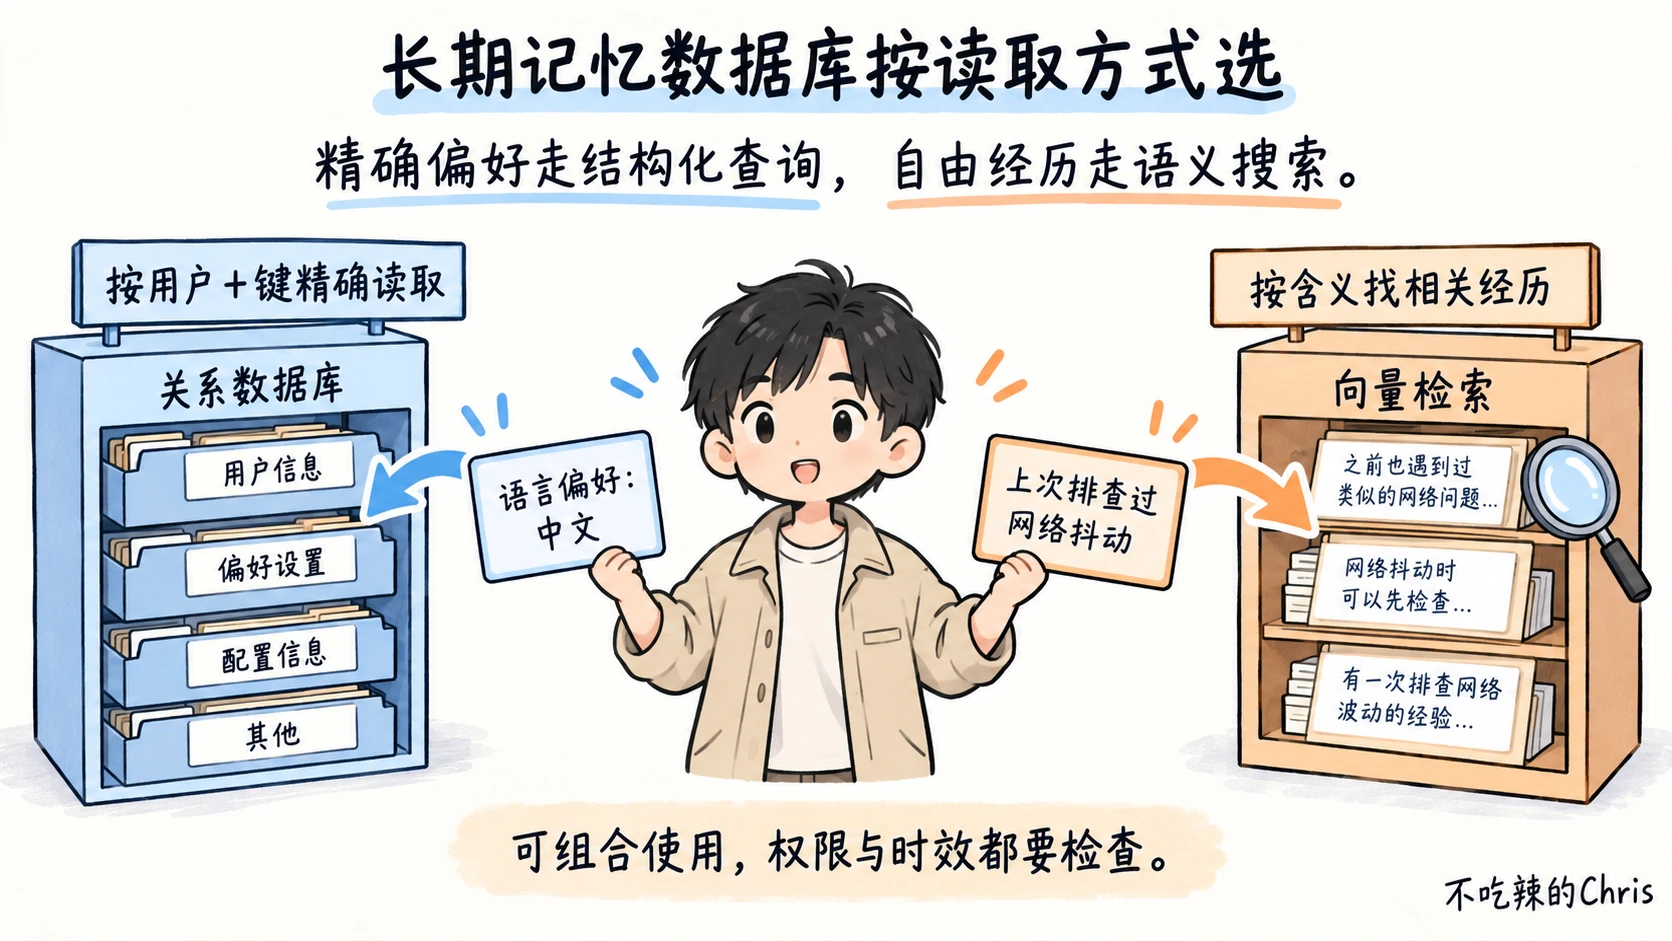
所谓“长期记忆数据库”不是某个唯一产品名。可用的包括带向量能力的关系数据库(如 PostgreSQL + pgvector)、文档数据库(如 MongoDB)、支持搜索的 Redis,以及专用向量数据库(如 Qdrant、Milvus)。它们也可以组合使用。先问清记忆长什么样、如何按用户隔离、如何更新和删除,再谈产品名字。图里把最常见的两种读取需求分开:精确偏好按用户和键查,自由文字经历按含义查。
术语和本例中的数据
| 词或符号 | 含义 |
|---|---|
U7 | 已从服务端登录会话确认的虚构用户编号;不能让模型或前端自行指定要查谁的记忆。 |
| 记忆条目 | 一条可复用的记录,例如“U7 希望用中文回答”或“U7 曾排查网络抖动”。 |
| 结构化偏好 | 有明确字段和值的记忆。本文用 preferred_language=zh 表示“首选语言是中文”。 |
| 自由文字经历 | 无法预先穷举字段的一段历史经验,本文是上月网络故障的原因与处理步骤。 |
| 主键 / 唯一键 | 数据库辨认一条记录的编号或字段组合。U7 + preferred_language 可防止同一偏好反复写出冲突副本。 |
| SQL / 关系数据库 | 用表、行、列和查询条件管理数据;PostgreSQL 是一种关系数据库。 |
| 文档数据库 | 通常把一条记录作为字段可变的文档保存;MongoDB 是代表性产品。 |
| 向量 / Embedding | 模型把文字转成数字数组,以便估算文本含义的相近程度;向量本身不证明事实正确。 |
| 向量检索 | 根据当前问题的向量,找相似记忆;能找到“网络忽快忽慢”与“网络抖动”这类用词不同但相关的记录。 |
| 过滤条件 / 元数据 | 在语义搜索前后限定归属用户、有效状态、时间等。相似度排序不能替代权限检查。 |
| 持久化 | 进程或机器重启后数据仍能恢复。是否持久,取决于数据库部署、备份和保留配置,不取决于产品名字听起来像“记忆”。 |
| 检查点 | 保存一次 Agent 会话的运行状态;它与跨会话用户记忆是不同的数据范围。 |
例子约定:U7 已同意保存偏好与故障摘要;语言偏好是 zh,上个月故障摘要经用户确认。今天问的是一个新问题,实时网络状态仍要通过诊断工具查,不能因为旧记忆出现“上次是路由器故障”就断定这次也是。产品中的“同意”“保留多久”要按自己的业务规则执行。
数据库首先要回答哪种查询
语言偏好应按 (owner_user_id, memory_key) 精确查。若今天读到 preferred_language=zh,Agent 就用中文回复;如果用户改为英文,更新同一键并确保旧值不再生效。精确值不需要先变向量再做相似搜索,因为“像中文偏好的记录”可能搜出别人或旧版本。
历史故障摘要则可能有数千条。今天用户说“网络忽快忽慢”,上次记录写“视频会议每几分钟卡顿”。只按关键词不一定命中,向量搜索可帮助找语义相关的旧记录。不过搜索必须把 owner_user_id=U7、有效状态等条件带进去,再按时间和证据核查。只看向量分数会出现最危险的误用:另一位用户的相似故障比 U7 自己的记录更相似,于是被拿来回答甚至泄露信息。
LangGraph 的官方文档把短期会话状态交给 checkpointer,把跨线程的长期信息放到 Store;Store 以命名空间组织 JSON 记忆,可选择启用语义搜索。这是框架层的抽象,不规定所有项目必须采用同一种后端。LangGraph:Memory · LangGraph:Persistence
常见存储方案分别适合什么
下面列的是有代表性的技术路线,不是市场份额排名。“主流”会随团队栈、数据规模和部署要求变化;选型要用自己的数据测试。
| 路线 | 适合先处理的记忆 | 好处 | 要实际验证的边界 |
|---|---|---|---|
| PostgreSQL,必要时加 pgvector | 用户偏好、状态、来源、版本、删除标记;少量到中等规模的语义经历也可放同库 | 精确查询、唯一约束、事务和审计字段易放在一起;pgvector 增加向量相似搜索 | 大规模向量索引与复杂过滤的性能要实测;近似索引可能漏结果,索引和查询参数需要调优。pgvector 官方项目 |
| Redis,按需启用搜索/向量能力 | 低延迟读取的偏好、热点摘要,或作为记忆服务的存储层 | 键值读取直接,也支持向量查询及元数据过滤 | 如果把它当长期权威库,必须核对持久化、复制、备份、淘汰与故障恢复配置;作为缓存时还要解决过期和失效同步。Redis 向量搜索文档 |
| MongoDB 配合其向量搜索能力 | 字段常变的记忆文档,且团队已有文档数据库运维能力 | 文档内容、元数据与向量可放在一套数据模型中,支持搜索时过滤字段 | 确认所用部署版本、索引和过滤语义;不能把数据库支持的过滤误认为应用已经做了用户授权。MongoDB Vector Search |
| Qdrant、Milvus 等专用向量库 | 大量自由文本经历,需要以语义相似度查找并按元数据筛选 | 提供向量与元数据搜索能力;Qdrant 把记录组织成 vector + payload,Milvus 文档有标量过滤方案 | 结构化偏好的唯一性、事务、更新顺序和跨库删除往往还需业务库配合;过滤条件和召回率要测试。Qdrant Points · Milvus filtered search |
pgvector 是 PostgreSQL 扩展,不是另一个独立数据库;它在表里增加向量列与相似度查询。Qdrant、Milvus 是以向量数据为主要能力的数据库,不代表所有记忆都应该向量化。Redis 也并非只能做缓存;但“我用 Redis”这句话不足以说明重启、淘汰、备份后长期记忆是否仍在。选型时要看真实配置。pgvector 项目文档 · Redis 向量搜索文档
用同一个客服场景走一遍方案选择
假设目前每位用户只有语言、联系方式偏好等十几个确定字段,故障历史也不多,团队已经在用 PostgreSQL。先用一张业务表管理 owner_user_id、memory_key、value、source、updated_at、status;给 (owner_user_id, memory_key) 加唯一约束。今天查语言只需要“用户 U7 的 preferred_language”,这类查询既清楚又容易测试。
如果积累了大量故障摘要,再增加语义索引。可以继续用 PostgreSQL + pgvector,把向量和同一条记忆的归属字段放在一张表或关联表;也可以让 PostgreSQL 保存权威记录,另把可检索副本建到 Qdrant/Milvus。选择后者时要承认有两份数据:用户删除记忆后,向量索引的旧副本也必须删除或立即对外不可见;不能说“业务表删了,所以隐私问题已经解决”。
一个不会把业务和搜索弄混的读取过程是:
text
user_id = verified_user_from_session(request)
language = db.get_preference(user_id, "preferred_language")
similar_ids = search_index.find_similar(
    query="网络忽快忽慢",
    filter={"owner_user_id": user_id, "status": "active"},
    limit=3
)
memories = db.load_authorized_current_records(user_id, similar_ids)这是说明职责的伪代码,不是某个产品可直接复制的 API。request 是今天的请求;verified_user_from_session 从服务端身份取 U7;language 是精确偏好;similar_ids 只是向量搜索给出的候选编号;最后 db.load_authorized_current_records 再到权威记录查归属、是否删除、版本和时效。这样即使搜索索引短暂落后,也不会直接把过期或别人的候选文本塞给模型。读完旧故障后,还需用诊断工具查看今天的网络状态。
双库写入可能中途失败:业务库写成功,向量索引还未写入;或记忆已删除,索引尚未清理。可用数据库事务先提交权威数据和“待更新索引”事件,再由后台任务重试建索引;检索后始终回查权威库。这样能容忍搜索暂时缺失,不容忍把已删除内容对外使用。对于严格的删除时效,还要按业务要求设计同步失效、缓存清理与监控。若全部留在一库,也要测试索引更新是否及时以及备份恢复后向量与文本是否对应。
选型时怎样问出真正的需求
别只问“哪家向量库效果最好”,至少把以下条件写成测试样本:
- 记忆类型:精确偏好、可更新的任务事实、自由文本经历各占多少;是否需要跨用户共享的公共知识。公共知识和用户私有记忆要分清归属。
- 隔离与删除:多用户或多租户如何限定读取范围;删除和修改后多久对所有读取路径生效;缓存、备份与索引怎样处理。
- 查询表现:先按用户过滤再找相似内容时,真实数据上的召回率和延迟;不能只用全库无过滤的漂亮基准数字。pgvector 文档也提醒近似索引与过滤组合可能影响返回条数。pgvector 过滤说明
- 写入和成本:每天新增多少记忆、要不要重算向量、备份体积及运维人力。小规模、结构化数据未必需要独立向量集群。
- 故障行为:主库、索引或缓存不可用时,Agent 怎样降级;不能串用户、不能把过期记录当权威事实。
按这个例子,先用已有 PostgreSQL 实现精确偏好和审计,再依据故障摘要规模实测 pgvector;只有单库方案确实达不到过滤、召回或吞吐要求时,再增加专用向量库,是一种可解释的工程起点。已有 MongoDB 或 Redis 能满足同样测试时,也无需为了追逐数据库名称迁移整套系统。
面试时怎么回答
AI Agent 的长期记忆可以放在 PostgreSQL、MongoDB、Redis,或 Qdrant、Milvus 等向量库里,也可以组合;没有“记忆必须用向量数据库”的规定。我会先区分数据和查询:像“用户 U7 希望用中文回答”是结构化偏好,按用户和字段精确读写,适合有唯一约束和版本管理的业务库;像“上次怎样处理网络抖动”是自由文字经历,可以用向量检索找相似记录。PostgreSQL 加 pgvector 能在一套系统里兼顾两类查询;已有文档库或 Redis 可按能力和持久化配置评估;数据规模大且语义检索复杂时可以再引入专用向量库。无论哪种库,服务端身份隔离、时效、来源、更新和删除都必须由应用控制。双库时业务库保存权威记录,向量结果只当候选并回查,避免旧索引泄露已删除或他人的记忆。
如果追问“Redis 速度快,是不是就最合适”,要回答:速度只是一个维度。长期记忆还需要重启恢复、备份、删除传播、权限、查询模式和运维成本。若追问“向量分数最高就是最该用的记忆吗”,回答也是否定的:分数只表示相似,不能证明归属当前用户、内容未过期或适用于今天的任务。
资料依据
- LangGraph:Add memory 与 Persistence:线程状态、长期 Store 与可选语义搜索。
- pgvector 官方项目:PostgreSQL 向量列、近似索引及带条件查询。
- Redis:Vector search concepts:向量查询和元数据过滤。
- MongoDB:Vector Search:文档与语义搜索的组合。
- Qdrant:Points 与 Milvus:Filtered Search:向量记录、元数据和过滤。