Appearance
Q36 · 什么是 HNSW?它和暴力检索有什么区别?
客服系统有一批政策片段,用户问“耳机退货期限是什么?”程序把问句和每条政策都表示成向量,想找与问题最接近的片段。最直接的办法是逐条计算距离,把所有片段都看过后选最近的几个;这叫暴力检索或穷举检索。若片段从几百条变成数百万条,每次请求都扫描全部向量,查询成本会随库规模增长。
HNSW(Hierarchical Navigable Small World,分层可导航小世界图)用索引换查询速度:预先把向量连成多层近邻图,查询先在稀疏上层找大方向,再逐层下降,在密集底层细找附近候选。它通常只计算所访问节点的距离,因而可以比全量扫描快;代价是建图与存图要花时间和内存,搜索返回的是近似最近邻,可能漏掉真正最近的点。原论文将它定义为分层图上的近似 K 近邻搜索方法。Malkov 与 Yashunin,HNSW 原论文 · Faiss 官方索引说明
把术语和符号一次说明白
| 术语或符号 | 在本文中指什么 | 政策检索中的对应物 |
|---|---|---|
| 向量 / embedding | 模型把文本变成的一串数字,用于比较相似程度;向量近不保证政策一定有效 | “耳机退货期限”问句和各条政策的数字表示 |
| 距离函数 | 给两个向量计算“有多近”的规则;可用欧氏距离、内积或余弦相关方式,但索引与查询必须采用相容的配置 | 问句与某条政策的距离是 0.08 |
| 最近邻 | 按指定距离函数,与查询向量最接近的库中向量 | 最接近问句的政策片段 |
K 近邻 / k | 要返回最近的 k 个结果;k=1 只取一个 | 先取 5 条候选供后续重排 |
N | 索引中向量的总数 | 全站有 N 条政策片段 |
d | 每个向量的维度,即有多少个数值 | 每条向量有 d 个分量 |
| 暴力/穷举检索 | 对全部 N 个向量逐一算距离,再取最小的 k 个 | 从第一条政策比到最后一条 |
| ANN(近似最近邻) | 为速度放宽“必须找到数学上真正最近的点”的要求 | HNSW 可能给出很近却不是最近的政策 |
| 近邻图 | 向量是节点,相近节点之间连边;搜索沿边走 | 政策片段之间的相似度道路 |
| 层级 | 底层容纳全部节点,上层越来越稀疏;上层用于粗定位 | 先到退货大类,再找耳机具体条款 |
M | 建图时控制每节点邻接连接规模的主要参数;具体连接数受实现与层影响 | 更大的 M 通常有更多可走的路,也更占内存 |
efConstruction | 插入节点时搜索邻居所用的候选宽度 | 建索引阶段愿意多花多少搜索工作 |
efSearch | 查询时保留并探索候选的宽度;有些库叫 hnsw_ef | 找耳机条款时搜索得有多宽 |
召回率 Recall@k | 近似检索返回的前 k 个结果,与精确检索前 k 个结果有多少重合;通常在多条查询上统计 | 与暴力检索的标准答案比对 |
N 和 d 决定穷举距离计算的主要工作量;k 是输出个数,不是图的层数,也不是 efSearch。下文的距离值是用于教学的虚构数字,只比较大小,不能拿去解释真实 embedding 模型的绝对分数。
同一问题,暴力检索怎样做
假设知识库里只有 8 条政策片段。把用户问题变成查询向量 q,对每条片段向量 vᵢ 计算距离 dist(q, vᵢ);vᵢ 表示第 i 条向量,dist 是已选好的距离函数。教学数据如下:
| 片段 | 内容摘要 | 到 q 的距离 |
|---|---|---|
| D1 | 会员政策 | 0.83 |
| D2 | 下单流程 | 0.62 |
| D3 | 支付方式 | 0.75 |
| D4 | 配送说明 | 0.44 |
| D5 | 一般退货说明 | 0.12 |
| D6 | 换货规则 | 0.31 |
| D7 | 耳机退货期限 | 0.08 |
| D8 | 售后联系方式 | 0.56 |
暴力检索算完 8 次距离,k=1 时确定 D7 最近;若有 N 条、每次计算距离要处理 d 个分量,则距离计算工作量随 N × d 增长。取前 k 个还需维护候选排序,但核心是每个向量都被比过。Faiss 将 IndexFlatL2 与 IndexFlatIP 列为穷举的精确检索索引;“精确”是相对于当前存储的向量和指定距离函数而言,不保证语义判断、版本有效性或最终业务答案正确。Faiss:Faiss indexes
当库很小、查询量低、必须得到精确最近邻,或者要给 ANN 算法准备标准答案时,暴力检索很合适。它基本不需要额外图结构,也没有“图走错路”的近似误差;但数据量很大且频繁查询时,每次全扫可能成为延迟瓶颈。小库、批量计算、硬件加速等条件下,实测表现还可能优于建索引后的方案,所以不能仅凭名称断定 HNSW 一定更快。Faiss:Guidelines to choose an index
HNSW 的图是怎么建、怎么走的
把 8 个片段想成城市里的地点。若只有底层的“街道”,可能需要绕很多步;HNSW 再加少量上层“快速路”,帮助搜索跨区域移动。真实算法不是按“会员区、售后区”手工分类,而是按向量距离与图连接构造这些路。
建图时,向量逐个插入。每个新节点会被随机分配一个最高层级:所有节点在底层,越往上节点越少。算法从现有入口的最高层寻找新节点附近的位置,逐层下降,再在相关层选邻居并建立连接;邻居选择还会考虑连接的多样性,以免路全挤在同一方向。原论文把层级、入口搜索、近邻连接与选择启发式作为算法核心。HNSW 原论文摘要与算法
查询时,搜索从上层入口开始,只比较当前节点及其邻居:往更接近查询向量的地方走;在上层做粗导航,逐层下降。到最底层时保留一组候选继续探索,最后从已访问的候选中返回 k 个最近的。原论文的搜索算法在上层使用很窄的贪心导航,在底层使用宽度为 ef 的候选搜索;Faiss 将查询时的参数称为 efSearch。HNSW 原论文 Algorithm 5 · Faiss:HNSW 参数
用上面的教学距离走一条简化的可能路径:上层从 D2(距离 0.62)出发,下一层走到 D6(0.31),底层找到 D5(0.12);若本次候选宽度太小,图路径没有触及 D7(0.08),就会把 D5 当作最好的结果返回。D5 并非“完全无关”,但它不是数学上的最近邻。扩大候选宽度可能让搜索继续遇到 D7,提高召回,也会多做距离计算。真实 HNSW 在底层维护多个候选,不是严格的一条单线路径;这个三站例子只说明可能跳过未访问节点的原因。
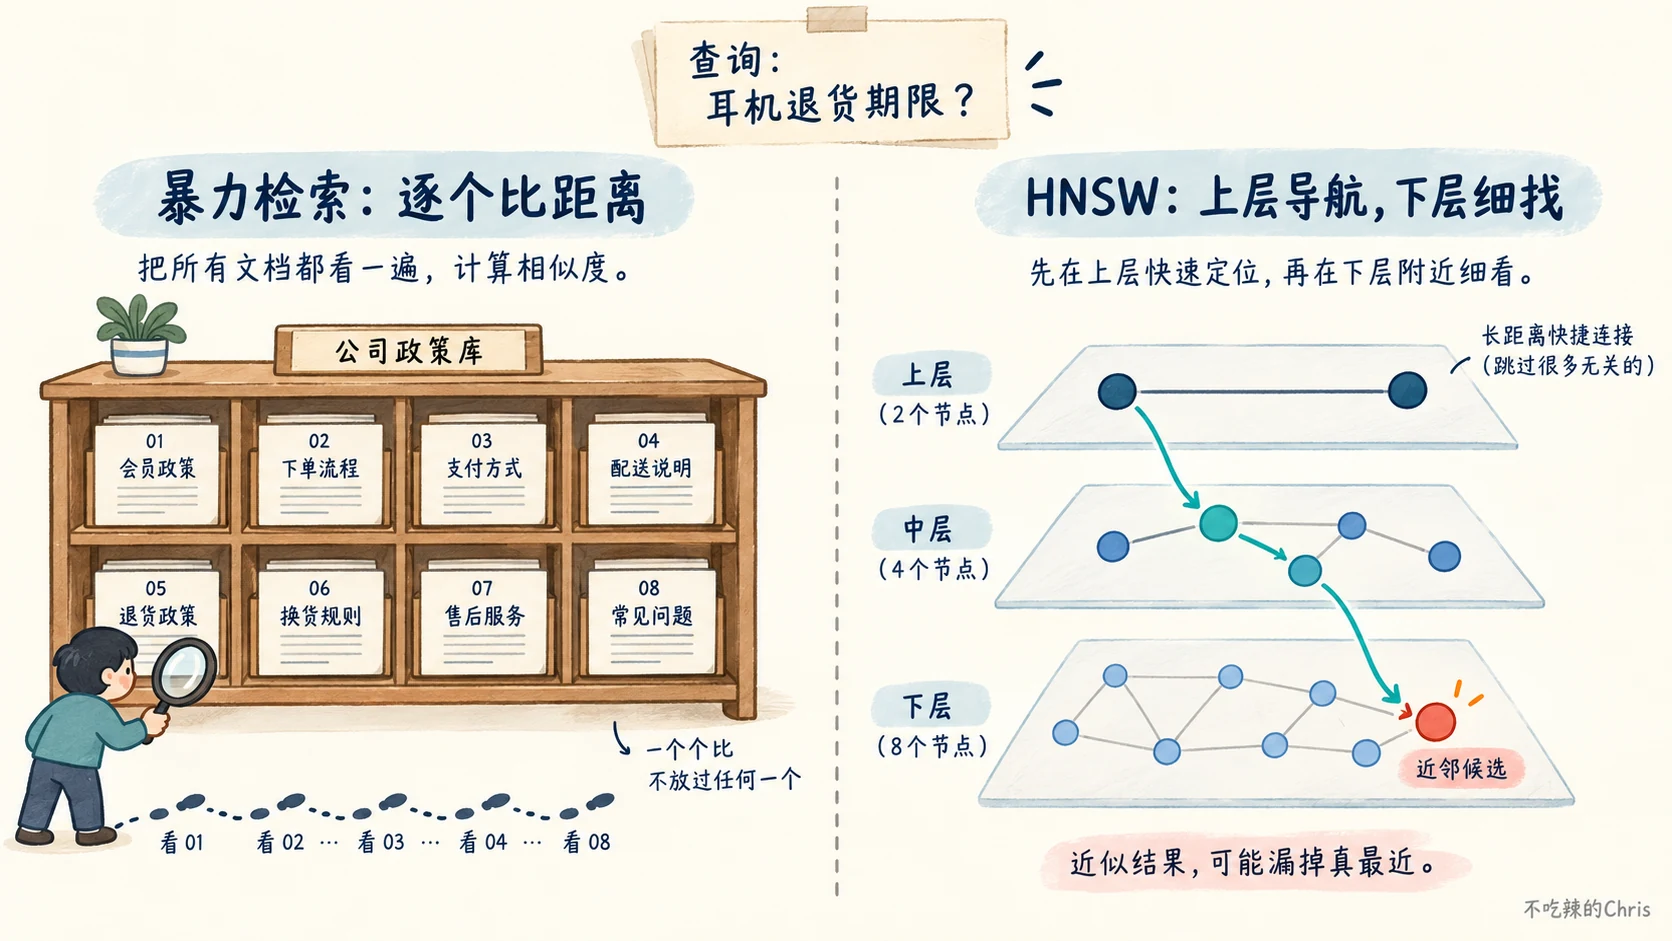
图左侧的柜子表示穷举法会逐个检查所有政策卡片;右侧三层图表示 HNSW 的导航路径。红点标为“近邻候选”,不是保证的精确最近邻。真实多层图的节点数、边和路径由数据与参数决定,图上的 2/4/8 节点只是教学比例。
两种方法究竟交换了什么
| 对比项 | 暴力检索 / Flat | HNSW |
|---|---|---|
| 搜索范围 | 对所有 N 个向量算距离 | 沿图访问一部分节点并扩展候选 |
| 结果保证 | 在存储向量与指定距离函数下得到精确前 k 个 | 近似前 k 个,可能漏真最近邻 |
| 索引准备 | 存向量即可,结构简单 | 插入时建多层图与连接,需要构建时间 |
| 内存 | 主要是向量及必要 ID/元数据 | 向量之外还要存图边等结构 |
| 查询调整 | 主要由硬件、批量方式和过滤决定 | 可用 efSearch 调整召回与延迟 |
| 适合 | 小库、低查询量、强精确要求、评测基线 | 大库、高查询量、允许少量近似误差且能承受图开销 |
不要把 HNSW 的“更快”写成固定复杂度承诺。 原论文报告了多层导航带来的良好扩展表现,并描述对数式的复杂度增长;实际查询访问多少节点,受向量分布、图质量、参数、过滤、硬件及实现影响。暴力检索的距离计算量随 N 线性增长比较明确;HNSW 的性能则应以自己的数据和召回目标实测。HNSW 原论文
还有一个容易误解的名字:Faiss 的 IndexHNSWFlat 里,Flat 指底层仍保存可直接访问的向量,整个索引的查询并不是 Flat 暴力扫描。同样,HNSW 删除支持也因实现而异;Faiss 文档明确说它的 IndexHNSW 不支持直接删除向量,不能因此推断所有向量库都完全不能删除。Faiss:IndexHNSW variants
参数怎么调,如何知道有没有丢关键政策
M 控制邻接连接规模。路多通常更容易找到正确邻居,但图更占内存、建索引也更费工。efConstruction 控制插入时搜索候选的宽度,通常在建索引阶段影响图质量与构建开销。efSearch 控制查询时底层候选探索宽度,增大它通常提高召回,也增加查询工作量与延迟。具体参数名和默认值依赖实现;不要把某个库的默认值当成 HNSW 原论文的固定标准。Faiss:HNSW 参数 · Qdrant:Candidate depth
实测时,先在同一批政策向量上用相同 embedding、距离度量、数据版本和过滤条件跑暴力检索,得到每条问题的精确前 k 个;再跑不同 M、efConstruction、efSearch 的 HNSW。记录 Recall@k、p50/p95 查询耗时、建图耗时、内存以及更新成本。例如 100 个问题、每题取前 10 条,若 HNSW 总共找回了精确检索结果中的 930 条(标准共有 1000 个结果位置),可称这批测试的微平均 Recall@10 = 930/1000 = 93%。同时单独观察“耳机 7 天”这样的业务关键条款是否被漏掉:总体召回高,也可能恰好漏掉不能漏的政策。
这里的精确前 k 是向量距离的参照,不是人工标注的“答案正确文档”。一个语义上相似但已过期的政策也可能排得很近;RAG 还需做版本、生效期、权限过滤及最终回答核验。过滤条件很严时,图搜索的可达候选可能改变,得在真实过滤组合下测。Qdrant 官方也说明小片段可能直接使用穷举搜索,届时 hnsw_ef 不影响结果;这再次说明“选了 HNSW 配置”不等于每次查询都沿图走。Qdrant:Candidate depth · Qdrant:Indexing
面试时可以这样回答
HNSW 是一种近似最近邻的多层图索引。暴力检索对库里每个向量计算与查询向量的距离,能得到指定距离函数下精确的前
k个,但工作量随向量总数增长。HNSW 预先把相近向量连成图:稀疏上层用于快速导航,密集底层用于细找候选,所以查询常常只访问部分节点;代价是建图和存边的开销,而且可能漏掉真正最近的点。实践中我会用 Flat 精确结果做基线,调M、efConstruction和efSearch,同时看Recall@k、延迟、内存及业务关键证据的命中。小库或必须精确时可直接用暴力检索;大库且查询频繁、可以接受受控近似误差时再考虑 HNSW。HNSW 找到的是向量近邻,仍需检查文档版本、权限和最终答案。
参考资料
- Malkov 与 Yashunin:HNSW 原论文 —— 多层近邻图、构建与搜索算法。
- Faiss 官方 Wiki:Faiss indexes —— Flat 与 HNSW 索引、参数及实现限制。
- Faiss 官方 Wiki:Guidelines to choose an index —— 索引选型与资源权衡。
- Qdrant:Candidate depth ——
hnsw_ef与精确搜索基线的召回对照。