Appearance
Q2 · 什么是工具调用(Tool Calling / Function Calling)?
难度 P0 必背 · 岗位 算法 / 应用 · 预计阅读 10 min 关键词 tool-calling · function-calling · json-schema · parallel-call
用户问“我的订单今天能退款吗”,模型没有订单数据库的实时数据。应用可以把 get_order 这样的查询能力提供给模型:模型提出“查这个订单”的请求,程序核对权限并执行,再把结果交还模型组织回答。这就是工具调用的基本分工。
先认清几个词
| 词 | 含义 | 在订单例子里 |
|---|---|---|
| Tool Calling / Function Calling | 模型按工具约定提出结构化调用请求的机制 | 提出调用 get_order 的请求 |
| Schema | 工具名称、参数和类型等约定 | 说明订单号是必填字符串 |
| JSON | 表达结构化数据的文本格式 | 请求中的工具名和参数 |
tool_calls | 模型返回的一组工具调用请求 | 一次请求中可能包含多个查询 |
| Tool 结果 | 程序执行工具后送回模型的数据 | 查询到的订单状态 |
模型决定要请求什么,程序决定是否允许以及怎样执行。 工具参数即使符合 Schema,也仍须校验订单归属、权限和业务条件。
从请求到结果

逐步拆开看
Function Calling 我的理解是这样一套机制:开发者用 JSON schema 把工具描述好传给模型,模型判断需要调工具的时候不输出自然语言,而是直接输出一段结构化的 tool_calls JSON,告诉你「我要调哪个函数、参数是什么」,你的代码拿到这段 JSON 去真正执行,把结果塞回对话,模型再生成最终答案。
整个流程本质上是两轮对话 :第一轮模型说「我需要调这个工具」,你去执行,第二轮模型拿到执行结果说「答案是这个」。
我觉得最核心的设计是,模型全程只做决策,执行的事情一律由宿主代码完成 ,职责分得很清楚。
Function Calling 解决了什么问题
LLM 在没有 Function Calling 之前,想让模型帮你调工具,完全靠解析自然语言。模型输出「我需要查一下北京的天气」,你再写 if/else 判断它「说」的是要查天气,然后手动去调 API。这个做法极其脆弱,模型换个说法,你的 if/else 就失配了,也根本没办法标准化。
Function Calling 的出现把这件事固定下来了:模型不再「说」要调工具,而是直接输出一段结构化的 JSON,开发者按格式解析就行,准确率大幅提升,也有了统一标准可以对接。这套机制由 OpenAI 在 2023 年推出,现在 Claude、Gemini、Qwen 等主流模型都支持。
三个角色:把 Function Calling 理解成一场任务委托
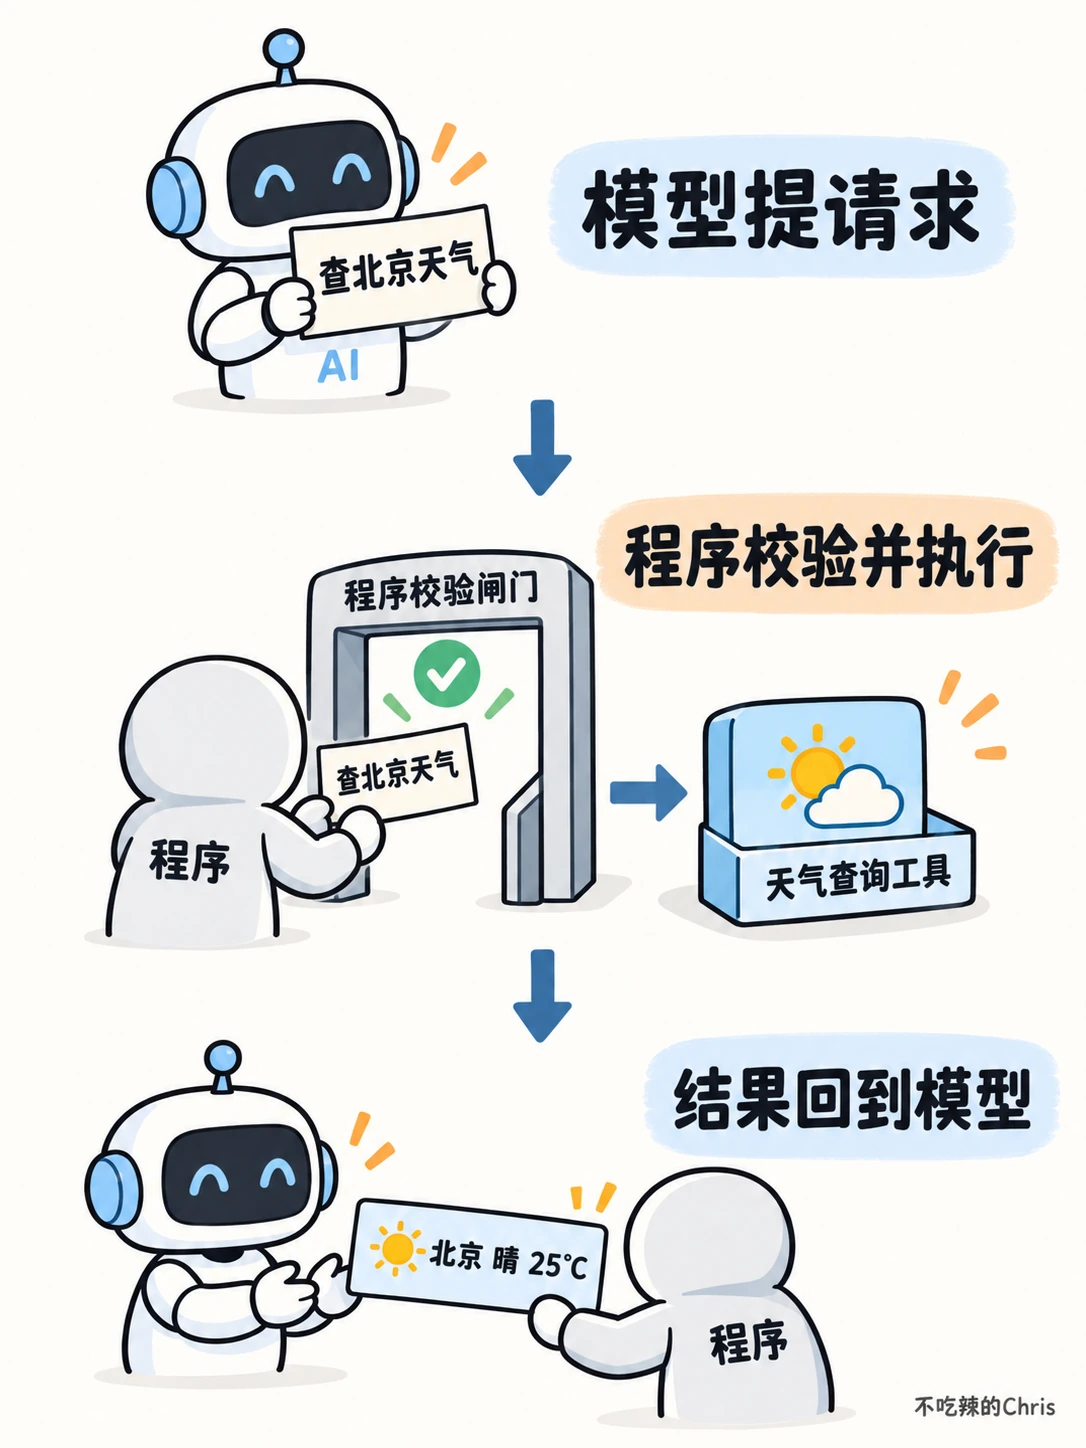
理解 Function Calling 的关键是搞清楚谁做什么。可以把这套流程理解成一场「任务委托」:
开发者是 HR :负责给每个工具写「职位说明书」,就是 JSON schema,告诉模型「我们有哪些工具、每个工具能做什么、需要哪些参数」。
模型是经理 :读完说明书之后决定「这个任务需要调哪个工具、参数填什么」,然后把指令下达出来。
你写的代码是员工 :真正去跑函数、访问网络、查数据库,把结果汇报回来。
关键点 :模型全程只是在「下指令」,它不亲自执行任何代码,也没有直接访问网络的权限。执行的事一律由宿主程序代码完成,这个分工要想清楚。
工具定义:Schema 的每个字段都有含义
工具 schema 就是一份结构化的「工具说明书」,用 JSON 格式写,告诉模型这个工具叫什么、能做什么、需要哪些参数。
python
tools = [
    {
        "type": "function",
        "function": {
            "name": "get_weather",  # 工具的唯一标识,模型输出 tool_calls 时会用这个名字
            "description": "查询指定城市的实时天气,包含气温、天气状况、风向风速,仅支持中国大陆城市",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "城市名称,如「北京」「上海」,不要带省份前缀"
                    },
                    "unit": {
                        "type": "string",
                        "enum": ["celsius", "fahrenheit"],
                        "description": "温度单位,默认用摄氏度"
                    }
                },
                "required": ["city"]
            }
        }
    }
]
其中最关键的字段是 description。这里停一下,你想一个问题:如果 description 写得含糊,模型会怎么表现?答案是它会「瞎猜」,比如你只写「获取天气」,模型可能拿到一个带英文名的城市也照样调,拿到「这周天气如何」这种时间跨度不对的问题也硬往里塞,调完之后发现返回的数据根本对不上。模型在决定「要不要调这个工具、参数怎么填」的时候,能依赖的唯一依据就是这段描述。
你可以对比一下:
text
❌ 差:"获取天气"
✅ 好:"查询指定城市的实时天气,包含气温、天气状况、风向风速,仅支持中国大陆城市"
写得越清晰,模型的选择越准确。参数的 description 同理,格式要求、示例值、限制条件都要写进去 ,模型才能正确填写参数。
完整调用流程:两轮对话 + 中间执行
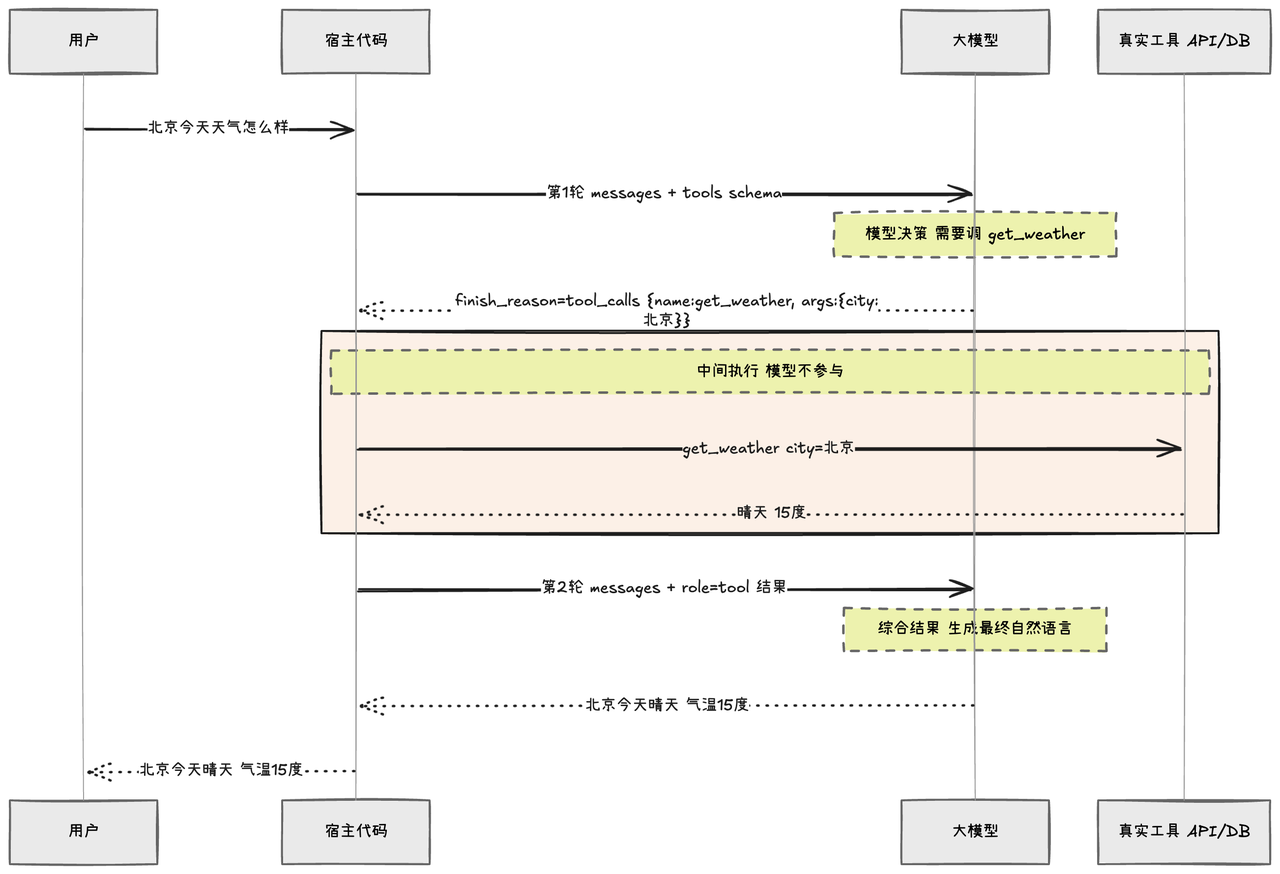
Function Calling 的运行时本质上是「两轮对话 + 中间执行」的闭环。
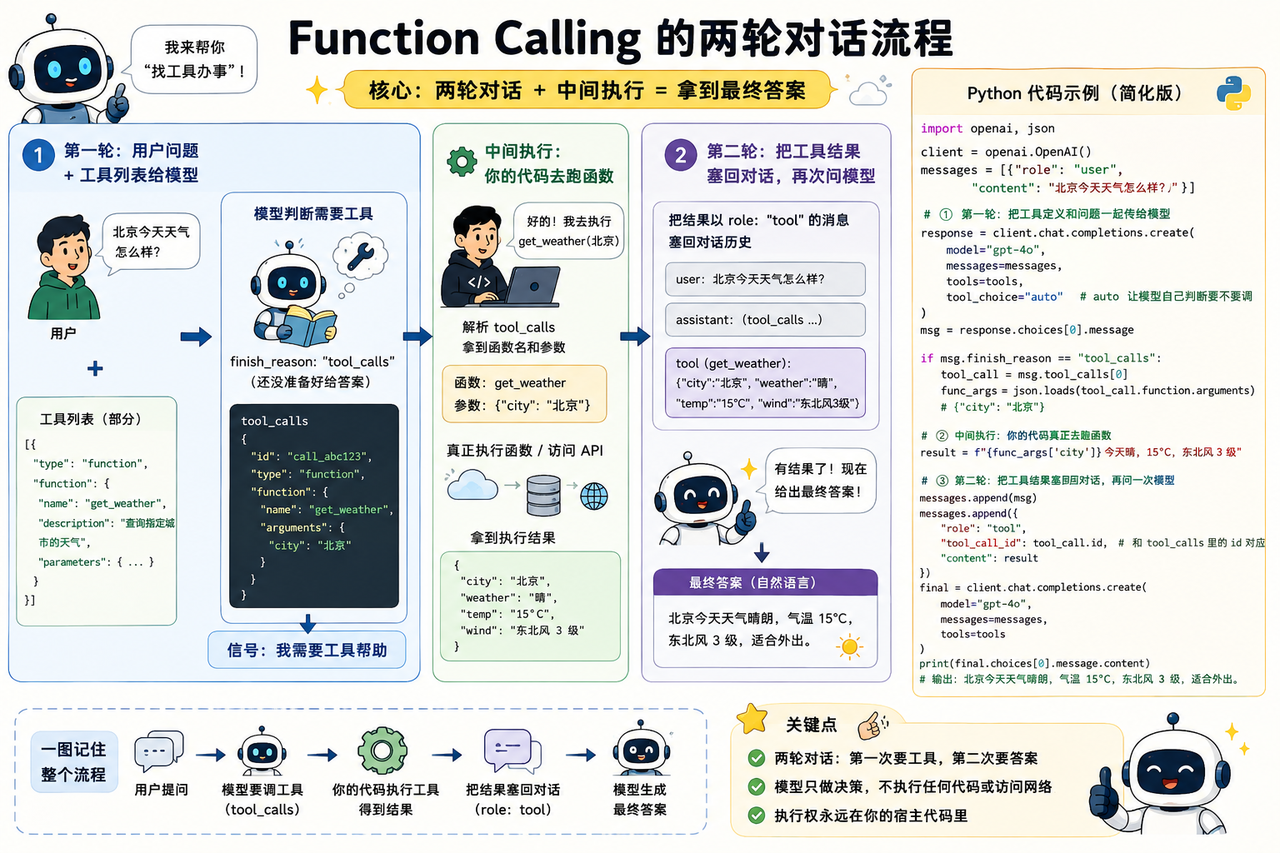
第一轮 :你把工具列表和用户的问题一起传给模型。模型读完之后,如果判断需要调工具,就不直接输出最终答案,而是输出一个 finish_reason 为 "tool_calls" 的响应,里面包含要调用的工具名和参数。这是个明确信号,告诉你「我需要工具帮助,还没准备好给答案」。
拿到这个信号之后,中间环节就交给你的代码 。你的代码解析 tool_calls 拿到函数名和参数,找到对应的函数跑一下,拿到执行结果。
第二轮 :把工具执行结果以 role: "tool" 的消息塞回对话历史,再次调用模型。这次模型有了工具结果,有了充分信息,才给出最终的自然语言答案。
python
import openai, json

client = openai.OpenAI()
messages = [{"role": "user", "content": "北京今天天气怎么样?"}]

# ↓ 第一轮:把工具定义和问题一起传给模型
response = client.chat.completions.create(
    model="gpt-4o",
    messages=messages,
    tools=tools,
    tool_choice="auto"  # auto 让模型自己判断要不要调,也可以设 required 强制调
)
msg = response.choices[0].message

if response.choices[0].finish_reason == "tool_calls":  # 模型要调工具,还没给最终答案
    tool_call = msg.tool_calls[0]
    func_args = json.loads(tool_call.function.arguments)  # {"city": "北京"}

    # ↓ 中间执行:你的代码真正去跑函数
    result = f"{func_args['city']}今天晴,15°C,东北风 3 级"

    # ↓ 第二轮:把工具结果塞回对话,再问一次模型
    messages.append(msg)
    messages.append({
        "role": "tool",
        "tool_call_id": tool_call.id,  # 和 tool_calls 里的 id 对应
        "content": result
    })
    final = client.chat.completions.create(model="gpt-4o", messages=messages, tools=tools)
    print(final.choices[0].message.content)
    # 输出:北京今天天气晴朗,气温 15°C,东北风 3 级,适合外出。
并行工具调用
看完单个工具的流程,再来想一个问题:如果用户一口气问了好几件事,比如「帮我查北京、上海、广州三个城市的天气」,模型一次该调一个工具,还是可以同时调多个?这就要说到 Function Calling 的并行调用设计。

当用户的问题需要多个工具才能回答时,模型可以在一次响应里同时输出多个 tool_calls,tool_calls 是个列表,不只有一条。比如用户问「帮我查北京和上海的天气」,模型会一次返回两个调用请求,分别对应两个城市。
为什么要这么设计?你想一下,如果没有并行调用,模型先说「我要查北京天气」,你执行完喂回去,模型再说「我要查上海天气」,又一轮对话,这样两个工具串行要跑两轮,每一轮都有一次模型推理和一次工具执行的延迟,总耗时很长 。

有了并行调用,模型一次把两个调用请求都输出来,你的代码可以同时执行这两个工具(比如用 Python 的 asyncio.gather 或者多线程),拿到所有结果后一次性塞回对话,再调一次模型就拿到综合了多个工具结果的最终答案。两个工具可以在同一轮请求中并行执行,省去串行时的额外模型往返;随后仍需把结果交给模型形成答复,实际节省多少时间取决于工具耗时 。
不过要注意一点,并行调用的前提是这几个工具之间没有依赖关系 。查北京天气和查上海天气互不影响,可以并行;但如果是「先查用户的订单号,再用订单号去查物流」,第二个调用依赖第一个的结果,这种就只能串行,模型也会正确地分两轮来输出。
实现时容易出错的地方
踩坑 1:以为模型自己执行了工具
错误描述 :「Function Calling 让大模型能直接访问 API、查数据库」。
正确做法 :当模型选择使用工具时,它返回结构化调用请求 ,真正执行工具的是宿主代码。「模型决策、代码执行」是 Function Calling 的核心设计,必须强调。
踩坑 2:description 写得太敷衍
错误描述 :description: "获取天气" 这种一句话糊弄。
正确做法 :description 是模型选工具、填参数的唯一依据 。要写清楚:能干什么、不能干什么、参数格式要求、典型用法、限制条件。参考 OpenAI 官方建议,描述长度通常 50~200 字。
踩坑 3:忘了把 role: "tool" 的结果塞回对话
错误描述 :拿到 tool_calls 直接执行,然后用执行结果当作最终答复返回给用户。
正确做法 :必须发起第二轮对话 ,把执行结果以 role: "tool" + tool_call_id 的形式塞回 messages,让模型综合工具结果生成自然语言回答。否则用户拿到的是裸数据,没有解释说明。
踩坑 4:并行调用以为是并发就行了
错误描述 :「并行就是 asyncio.gather 一起跑」。
正确做法 :并行的前提是工具之间没有依赖 。有依赖的工具(如先查订单号再查物流),模型会自动分多轮串行;不要试图自己「优化」成并行,否则参数都填不出来。
踩坑 5:把 Function Calling 等同于 Agent
错误描述 :「我用了 Function Calling 调了一个 API,这就是 Agent 了」。
正确做法 :Function Calling 只是 Agent 的一个能力支柱 (行动力),Agent 还需要规划、记忆、闭环纠错。详见 Q1 什么是 Agent。
再往下追问时怎么解释

追问 1:
tool_choice有哪些取值?分别什么场景用? 答题要点:auto(默认,让模型自己决定要不要调)/none(禁用工具调用,纯文本回答)/required(强制必须调一个工具)/ 指定函数名(强制调某个工具)。required适合「用户问题一定要查工具」的场景,比如客服系统强制查订单。追问 2:如果模型选了不存在的工具或填了非法参数,怎么处理? 答题要点:核心是“校验 + 拒绝 + 重试”。工具名校验 :服务端检查模型返回的工具名是否存在,不存在就拒绝执行。 参数校验 :根据 JSON Schema 校验参数类型、必填项、枚举值等,非法参数不执行。 反馈重试 :把具体错误信息返回给模型,让模型修正工具名或参数后重新调用。 设置重试上限 :避免模型反复出错导致无限调用。 即:模型负责生成调用,系统负责严格校验;校验失败就不执行,并将错误反馈给模型重试。
追问 3:JSON Schema 太长会怎样?怎么优化? 答题要点:JSON Schema 太长,会增加 Token 消耗和上下文负担,还可能让模型更难准确选择和调用工具,导致响应变慢、成本上升、调用错误率增加。优化方法:精简 Schema :删除不必要的字段、描述和示例。 拆分工具 :一个工具不要承担太多功能,按业务拆成多个工具。 减少参数 :只保留模型真正需要填写的参数。 按需加载工具 :不要一次把所有工具的 Schema 都放进上下文,只提供当前任务相关的工具。 即:Schema 要做到“够用但不冗余”,通过精简、拆分、按需加载降低上下文负担。
追问 4:Function Calling 和 ReAct、Plan-and-Execute 的关系? 答题要点:Function Calling 是底层机制 (模型怎么输出调用请求),ReAct / Plan-and-Execute 是上层模式 (Agent 怎么组织多步推理)。ReAct 每步用 Function Calling 输出一个工具决策;Plan-and-Execute 一次规划完所有步骤,每步可能并行调多个工具。
追问 5:和 MCP 是什么关系? 答题要点:Function Calling 是模型层(输出调用请求格式),MCP 是应用层(工具暴露与发现协议)。互补:Agent 通过 MCP 发现可用工具 → schema 喂给 LLM → LLM 用 Function Calling 输出调用 → Agent 通过 MCP 真正执行。
面试中如何回答
回头看开头的面试对话,踩的雷其实很典型。
第一个误区 :以为模型能「自己」去访问网络、执行代码,这是对 Function Calling 最常见的误解。面试时一定要强调:模型全程只负责决策,输出结构化的 JSON 调用请求,真正执行工具的是你的宿主程序代码 ,这个职责分工是整个机制的核心设计。
第二个误区 :把 Function Calling 和之前靠解析自然语言调工具的「土办法」搞混了,Function Calling 的关键改进就是模型直接输出结构化 JSON 而非自然语言,让工具调用有了统一标准。
面试回答这道题,有几个点必须说到:
工具定义用 JSON schema 描述 ,description 字段是模型判断是否调用的核心依据
运行时是「两轮对话 + 中间执行」的闭环流程
模型通过
finish_reason="tool_calls"明确告知需要工具帮助模型支持一次返回多个
tool_calls实现并行调用
把这几个点讲清楚,再强调「模型决策、代码执行 」的分工原则,这道题就稳了。