Appearance
Q41 · 如何实现工具的并行调用?什么时候该串行?
用户对客服智能体说:“订单 A123 的耳机能退吗?顺便查一下我的积分。”系统需要做三次读取:查 A123 的订单、查当前用户的积分、查耳机类别的退货政策。若把三次请求排成一队,一个结束才开始下一个,用户会白等。但如果把它们不分条件地同时发出,政策工具在订单还没返回时可能连商品类别都不知道。
正确做法是先画出数据依赖:查订单与查积分互不需要对方的结果,可以同时开始;查政策要用订单返回的类别,必须等查订单完成;答复要看哪些结果成功、哪些失败,再合并。所谓并行工具调用,在这类远程查询里通常指异步并发:等待一个接口返回的同时,程序可以等待或处理另一个接口,而非一定让两个 CPU 核心同时计算。
官方文档也区分了“模型提出多个调用”与“应用怎样执行”。OpenAI 说明模型可能在一轮产生多个函数调用,应用可以用 parallel_tool_calls: false 限制每轮最多一个;Anthropic 明确指出多个工具调用可以由应用并发、串行或混合执行,选择取决于依赖和副作用。OpenAI:Parallel function calling · Anthropic:Parallel tool use
先把术语、数据和代码名说清楚
| 术语或符号 | 含义 | 本例对应物 |
|---|---|---|
| Agent / 智能体 | 模型与应用程序配合,决定查什么、接收结果并答复用户 | 客服问答程序 |
| 工具调用 | 模型或编排程序请求应用执行一项操作;实际数据库/API 请求由应用执行 | 查订单、查积分、查政策 |
| 串行 | 后一步开始前,必须等前一步结果 | 拿到订单 category 才查政策 |
| 并发 | 多项工作在时间上重叠推进,适合等待网络或数据库的任务 | 查订单和查积分同时等待各自服务 |
| 并行 | 日常讨论常把独立调用的并发执行也叫“并行”;严格说,物理同时运行与异步交错不是一回事 | 两个远程读取同时处于执行中 |
| 依赖 | 一个操作的输入或正确性依赖另一个操作的输出 | 政策查询需要订单里的商品类别 |
| 汇合 / fan-in | 等所需分支有结果或明确失败,再组合输出 | 退货结论与积分信息组成答复 |
| 副作用 | 操作改变外部状态 | 提交退款、扣积分;本例三次查询均只读 |
| 超时 | 为一次调用设置等待上限;达到上限后给出失败结果 | 积分服务过慢时报告暂不可查 |
order_id | 用户给出的订单号 | A123 |
user_id | 服务端从登录会话取的用户标识,不能让模型猜 | 演示用户 U9 |
category | 订单系统返回的标准商品类别 | earphone |
call_id / tool_use_id | 不同接口里用来对应请求与结果的调用标识 | 两个同名工具调用也能各自对上结果 |
文中的业务数据都是假设:当前日期为 2026-09-26;A123 在 2026-09-23 签收、显示未拆封、类别为 earphone;用户 U9 的积分为 240;演示政策是“签收次日起 7 个自然日内且未拆封,可申请退货,仍需审核例外条件”。这些不是某平台的真实规则。日期以签收日为起点,不能偷换成购买日。
先画依赖,再算能省多少等待
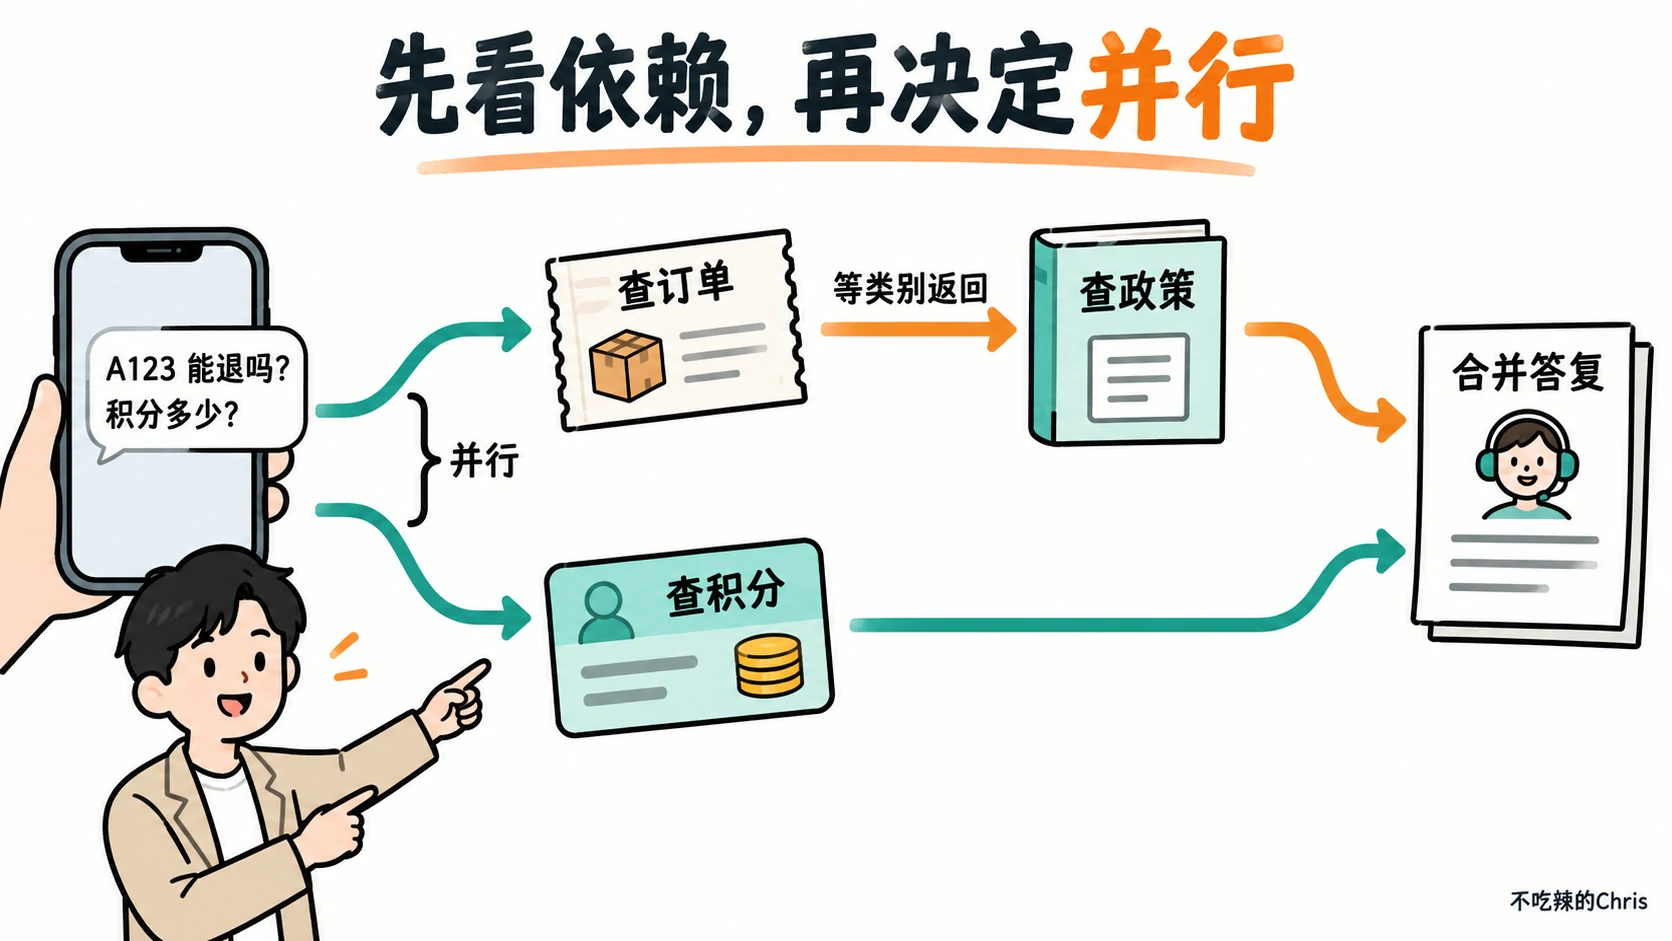
图上“查订单”和“查积分”从同一个用户请求分叉:它们都是只读,而且查积分不需要订单结果。查政策只能沿订单这条路继续,因为它的输入 category=earphone 必须从订单结果取得。最右边的答复收集两条分支;若积分超时,可以只对退货问题给有证据的答复,并明确积分暂不可查。
把三次服务用时记为 T订单、T积分、T政策。完全串行时约等于 T订单 + T积分 + T政策;按图执行时约等于 max(T订单 + T政策, T积分),其中 max 表示取两条路径中较慢的一条。比如订单 120 毫秒、积分 160 毫秒、政策 80 毫秒,串行约 360 毫秒,按依赖并发约 200 毫秒。这只是工具服务阶段的理想化估算,实际还要加模型调用、排队和网络开销,也不保证每次都快 160 毫秒。
决定能否并发时,逐对问三个问题:
- 输入是否已知? 查积分只要服务端
user_id,可以与查订单同时启动;查政策的category要等订单返回。 - 会不会互相改变状态? 两次纯读取通常容易并发;扣积分与提交退款若共享余额或订单状态,就要考虑顺序、事务和并发冲突。
- 业务上能否接受各自失败? 积分只是用户“顺便”问的附加信息,积分服务失败不必阻断退货问题;若政策不可用,就不能给确定的退货资格结论。
即使模型在同一轮提出“查订单”和“查政策”,也不能因为它们都出现在一轮就直接并发执行。若政策参数来自尚未查询的订单,应用应拒绝猜出的参数,等订单结果后再发起政策查询。某些接口会在模型输出中给每个调用单独的 ID;返回结果时要按 ID 配对,不能假设“第一个返回”就是“第一个发出”。OpenAI 的函数调用示例用 call_id 对应输出;Anthropic 的并行调用文档要求每个 tool_use_id 都有对应结果,并说明跳过的调用也要返回错误结果。OpenAI:工具结果与 call_id · Anthropic:执行语义
用 Python 跑出“先并发、后依赖、再汇合”
下面给一段可用 Python 3.9+ 直接运行的模拟程序,不需要安装第三方包或接真实模型。它展示的是应用的执行编排,不是某家模型 API 的完整接线代码。真实系统应把三个模拟函数换成带鉴权的数据库或 HTTP 客户端,并按提供商接口把每次调用结果连同调用 ID 交还模型。
先认识代码会用到的名字:
| 代码名 | 作用 |
|---|---|
get_order | 模拟用订单号查订单;输出类别、签收日和未拆封状态 |
get_points | 模拟从登录用户 ID 查积分;slow=True 用来制造慢服务 |
get_policy | 模拟按订单返回的类别查政策 |
guarded | 给单次工具调用加超时,并把成功或失败统一变成带 ok 的结果 |
answer | 负责按依赖启动三个操作,返回订单、政策和积分三份结果 |
order_task、points_task | asyncio.create_task 创建的两个已启动任务,分别代表并发中的订单和积分读取 |
seconds | 单次调用最多愿意等待的秒数;模拟值只为演示 |
slow_points | 是否让积分服务故意变慢,演示部分失败 |
async def 定义一个可以在等待 I/O 时让出执行权的异步函数;await 是等待某个异步结果;asyncio.create_task 会把异步函数安排为可并发推进的任务。asyncio.wait_for 到时会尝试取消被等待的任务并抛出超时错误;代码用 asyncio.TimeoutError 兼容 Python 3.9 与较新的版本。asyncio.gather 在代码末尾只负责等待子任务清理。Python 文档提醒,取消需要被调用方处理,因此实际总耗时可能超过设定的超时秒数;远程服务是否已经产生副作用,更不能只凭本地取消判断。Python:Coroutines and Tasks
python
import asyncio


async def get_order(order_id, user_id):
    await asyncio.sleep(0.12)  # 模拟网络等待
    if user_id != "U9":
        raise PermissionError("FORBIDDEN")
    if order_id != "A123":
        raise LookupError("ORDER_NOT_FOUND")
    return {
        "order_id": "A123",
        "category": "earphone",
        "signed_at": "2026-09-23",
        "unopened": True,
    }


async def get_points(user_id, slow=False):
    await asyncio.sleep(0.45 if slow else 0.16)
    if user_id != "U9":
        raise PermissionError("FORBIDDEN")
    return {"balance": 240}


async def get_policy(category):
    await asyncio.sleep(0.08)
    if category != "earphone":
        raise LookupError("UNKNOWN_CATEGORY")
    return {"version": "demo-2026-09", "days": 7,
            "starts_from": "签收次日", "requires_unopened": True}


async def guarded(operation, seconds):
    try:
        data = await asyncio.wait_for(operation, timeout=seconds)
        return {"ok": True, "data": data}
    except asyncio.TimeoutError:
        return {"ok": False, "error": "TIMEOUT"}
    except PermissionError:
        return {"ok": False, "error": "FORBIDDEN"}
    except LookupError as error:
        return {"ok": False, "error": str(error)}
    except Exception:
        return {"ok": False, "error": "UPSTREAM_ERROR"}


async def answer(order_id, user_id, slow_points=False):
    order_task = asyncio.create_task(
        guarded(get_order(order_id, user_id), seconds=0.30)
    )
    points_task = asyncio.create_task(
        guarded(get_points(user_id, slow=slow_points), seconds=0.25)
    )
    try:
        order = await order_task
        policy = {"ok": False, "error": "SKIPPED_NO_ORDER"}
        if order["ok"]:
            category = order["data"]["category"]
            policy = await guarded(get_policy(category), seconds=0.30)
        points = await points_task
        return {"order": order, "policy": policy, "points": points}
    finally:
        for task in (order_task, points_task):
            if not task.done():
                task.cancel()
        await asyncio.gather(order_task, points_task, return_exceptions=True)


async def main():
    print("正常:", await answer("A123", "U9"))
    print("积分超时:", await answer("A123", "U9", slow_points=True))


asyncio.run(main())
从 main 的第一行跟着执行:answer("A123", "U9") 一进入,就创建订单和积分两项任务;订单大约 0.12 秒后返回 category="earphone",于是程序开始查政策。此时积分仍在进行,不会因为程序正在等政策而停住。政策大约再过 0.08 秒返回;积分约 0.16 秒返回。因此三份结果可以汇合,输出里 order.ok、policy.ok、points.ok 都是 True。答复可以据此说明:按演示规则,9 月 23 日签收的 A123 到 9 月 26 日仍在申请期内,订单显示未拆封,初步可申请;积分余额为 240。例外条款与最终审核仍要核实,程序没有提交退款。
第二行把 slow_points=True 传给积分模拟函数,令其耗时约 0.45 秒;积分分支只等 0.25 秒,于是 points 变成 {"ok": False, "error": "TIMEOUT"}。订单和政策分支照常成功。合并答复时只陈述有证据的退货信息,再说“积分服务暂时超时,余额未查到”,绝不能把积分当成 0。guarded 把每一项成功、超时、无权限和查询失败包装成同一外形,让上层逐项判断。finally 则保证外层任务被取消时,不留下无人管理的订单或积分子任务;asyncio.gather(..., return_exceptions=True) 在此处只用于等待清理,不把异常默默当成业务成功。
还要看另一种失败:若订单号是 A999,get_order 返回 ORDER_NOT_FOUND,程序把政策标成 SKIPPED_NO_ORDER,不会猜类别继续查。积分仍可独立返回 240;答复应请用户核对订单号,并可报告积分。若政策返回 UNKNOWN_CATEGORY 或服务超时,订单存在也不足以断言能退。各分支的错误要保留自己的来源,不要把“政策没查到”写成“订单不符合退货条件”。
示例里每项服务是用 asyncio.sleep 模拟的可等待操作。若真实客户端是阻塞式函数,直接放进 async def 并不会自动并发,需要使用真正的异步客户端或受控线程池。真实系统还要加总请求截止时间、连接池和最大并发数,并把 user_id 从已验证的服务端会话取出;本地超时或取消不能当作远端写操作已撤销。
接上真实模型接口时,应用先读取模型提出的每个工具名、参数和调用 ID,逐个核对工具是否在允许列表、参数是否有效,再按依赖分组。对同一批独立调用,可用与上例相同的异步任务并发执行,并给每个结果保留原调用 ID;有依赖的调用则在前一结果回来后再执行,必要时让模型进入下一轮。最后按接口要求把每个已提出的调用对应的成功值或错误交还模型,而不是只把最快的一项结果发回去。OpenAI 使用与 call_id 对应的 function_call_output;Anthropic 使用与 tool_use_id 对应的 tool_result,且其并行文档要求同一轮的结果一起返回。两种接口的消息包装不同,不能把上面的 Python 模拟结果直接当作任一接口的请求体。OpenAI:函数结果示例 · Anthropic:并行结果格式
什么时候必须串行,什么时候可并发
| 情况 | 处理方式 | 原因 |
|---|---|---|
| 查订单、查积分,各自只需现成输入 | 并发 | 两次读取独立,等待可重叠 |
查政策需要订单返回的 category | 串行接在查订单后 | 输入依赖明确,提前调用只能猜 |
| 先修改订单状态,再读修改后的状态 | 串行,并验证读到的版本 | 后一步必须观察前一步结果 |
| 两个操作都要扣同一积分余额 | 不随意并发;由后端事务、锁或原子条件更新保护 | 并发可能造成超扣或丢失更新 |
| 提交退款等对外写操作 | 先鉴权、确认、校验状态,再执行;用幂等键防重复 | “同时发出”可能产生不可逆的重复动作 |
| 多个独立只读调用,但下游限流严格 | 限定并发数,必要时排队 | 过高并发会造成超时和服务拥塞 |
串行不等于一定慢:有依赖时串行是正确性要求。并发不等于一次发尽所有工具:即使两次读取相互独立,也要考虑下游容量和用户是否真正需要。工具调用中的“并行”更不能当成放宽权限检查的理由。对于对外写操作,先完成必要读取和用户确认,再以服务端校验执行;若写入失败或超时,用业务幂等键查询最终状态,不能盲目重试导致重复退款。
“失败汇合”也要有规则。退货结论依赖订单与政策两个必需结果,任一缺失就降低结论强度或停止判断;积分是独立的可选分支,超时不应被写成余额为零。若多个必需工具都失败,返回能让用户继续处理的错误,而非编一个完整答案。日志里记录每个工具的开始、结束、耗时、调用 ID、错误码和依赖关系,方便定位是模型选错工具、服务慢,还是编排顺序错。
面试中可以这样回答
“我先把工具调用画成依赖图。输入已知、互不改状态的读取可以同时启动;后一步要用前一步输出,就必须串行。比如用户问 A123 能否退货并问积分,查订单和查积分并发,订单返回商品类别后再查政策,最后按结果汇合。应用侧用异步任务执行,每项设超时和错误码,结果按调用 ID 对应;积分超时可以给退货部分答案,但订单或政策失败就不能断言能退。写操作、共享状态、先写后读以及需要用户确认的步骤要有明确顺序、权限与幂等保护。模型一轮提出多个调用,只表示有多个请求,能否真的并发仍由应用根据依赖和副作用判断。”
若追问“并发数越大越好吗”,可以回答:不是。延迟主要受最长依赖路径限制,继续增加与任务无关的调用只会占用连接、触发限流或扩大失败面。先统计每项服务的耗时和依赖,再设置并发上限、超时与优先级;为必需分支保留时间预算,附加分支失败时给清楚的部分结果。