Appearance
Q89 · 反射模式(Reflection Pattern)
客服助手收到一句话:“订单 A123 的耳机有杂音,能直接退款吗?”它很快写出:“您在 30 天内,可以直接退款。”读起来热情、流畅,但流畅不是正确:店铺政策允许在签收后 30 天内申请检测,是否退款要等检测和审核。把“可以申请检测”写成“可以直接退款”,会给用户一个未经授权的承诺。
如果在发送前让系统拿初稿和政策逐条对照,指出具体错误,再要求助手按反馈改写,就形成了反射模式:生成候选结果 → 检查候选结果 → 把可执行反馈交回生成者 → 必要时再生成。它可以提高某些任务的结果质量,但检查者如果只会说“写得不错”,循环本身不会带来可靠性。下面这张图只画第一次发现错误并修订的过程;真实系统还需要在修订后再次核验。
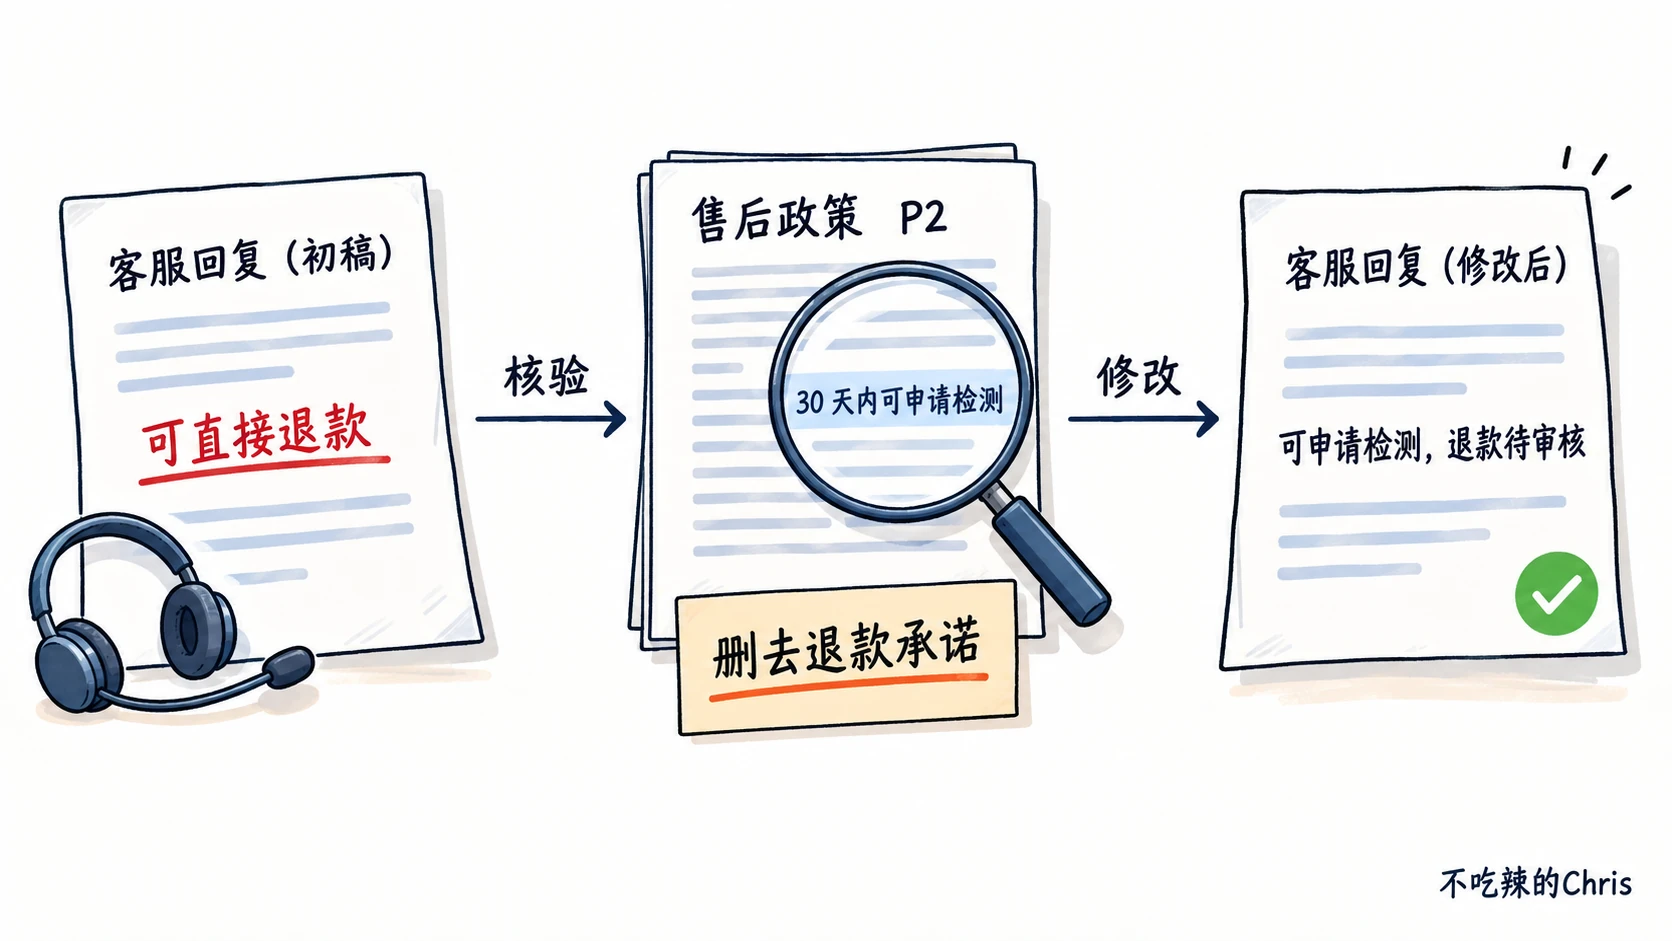
研究中的 Self-Refine 用同一个语言模型分别完成生成、提供反馈和修订,说明“反射”并不要求另训一个模型。Anthropic 的生成者—评估者流程则把生成与评估安排成两次调用,强调要有清楚的评价标准,而且迭代应带来可测量的收益。这里的“分开检查”指步骤与标准分开,不等于检查者天然客观;事实性结论仍应对照政策、订单数据、测试结果或人工判断。
术语与本例约定
| 词或符号 | 在本文中的含义 |
|---|---|
| 大语言模型 | 根据输入文字生成回答的模型。它能写出看似合理的句子,但文字流畅并不证明事实正确。 |
| Agent | 为完成目标而安排模型、知识查询和工具步骤的应用。反射循环可以是 Agent 的一环,也可以只是普通的固定工作流;有反射不自动等于有自主 Agent。 |
| 反射模式 / Reflection Pattern | 先产出候选内容,再根据评价反馈修改候选内容的一种迭代设计。这里的“反射”是工程流程,不表示模型有自我意识。 |
| 生成者 / 检查者 | 生成者写答复;检查者按标准检查答复并给出问题位置、证据和修改方向。它们可以是同一个模型的两次调用,也可以是不同模型、程序检查器或人工。 |
草稿 v0、修订稿 v1 | v0 是第一版待检答复;v1 是根据检查结果改出的第二版。版本号用于说明顺序,不表示质量必定递增。 |
| 评价标准 / 核验 | 评价标准是事先写明的检查项目;核验是拿内容与可信材料或可执行规则逐项比对。本文检查“退款承诺是否有依据”“是否说明下一步”“是否假称已执行操作”。 |
| 反馈 | 检查者指出可定位的问题与修订建议,例如“第 1 句承诺直接退款,但政策 P2 第 3 条只允许申请检测”。单独说“再严谨些”不是足够可执行的反馈。 |
| 外部证据 | 当前政策版本、订单记录、测试运行结果等不由这次草稿凭空生成的信息;它们也需要来源、时效与权限核对。 |
| 迭代 / 停止条件 | 一次“生成或修改 → 检查”算一轮。停止条件是通过核验、达到次数或时间预算、缺少可信证据、需要人工处理等。 |
A123、P2 | 教学用的虚构订单编号与售后政策版本号。它们不是任何真实商家的订单或承诺。 |
例子假设:今天是 9 月 20 日,订单 A123 由已登录用户本人提出,耳机于 9 月 10 日签收。虚构的有效政策 P2 第 3 条规定:“签收后 30 天内可申请故障检测;退款须依据检测结果并经售后审核。”P2 第 4 条要求客服不得把“可申请检测”表述为“保证退款”。此处仅演示答复起草,系统尚未创建检测单,也未发起退款;日期与政策均不是通用的消费者权益规则。
草稿怎样被检查和改写
生成者第一次拿到用户问题、订单的签收日期和一段政策摘要,写出 v0:
“您在签收后 30 天内,可以直接退款。我已经为您提交退款申请。”
这段话有两处错误。第一处把政策允许的检测申请说成直接退款;第二处把没有发生的退款提交说成已完成。检查者需要明确引用输入材料,并逐句说明错误;若只是让同一个模型笼统地“再想想”,它可能继续维护自己刚才编出的结论。
| 检查项目 | 对照材料 | v0 的结果与反馈 |
|---|---|---|
| 退款条件 | P2 第 3、4 条 | “可以直接退款”无依据;改为“可申请故障检测,退款待检测与售后审核”。 |
| 是否虚构动作 | 检测单与退款申请记录均为空 | “已提交退款申请”不真实;删去已完成表述,说明下一步是用户确认后再申请检测。 |
| 用户问题是否得到回答 | 用户问“能直接退款吗” | 先明确回答“目前不能承诺直接退款”,再说可走的路径。 |
检查者可以把反馈写成结构化记录:通过=false,问题句=第 1、2 句,依据=P2 第 3、4 条及申请记录为空,修订要求=删除保证退款和已提交表述。其中“通过”只表示这次检查按列出的标准未发现问题,不能升级为“全部事实已被证明”。
生成者收到 v0、原始问题和这份反馈后,产生 v1:
“目前不能承诺直接退款。您的订单在签收后 30 天内,按售后政策 P2 第 3 条可以申请故障检测;是否退款要看检测结果并经售后审核。如果您愿意,我可以为您说明如何提交检测申请。”
v1 没有声称已完成任何操作。检查者再对照 P2、签收日期和申请记录:政策条件与表述一致,也回答了用户的问题,才允许发送。图里的绿色勾代表这次已定义项目通过,并非整个售后结果已确定。真实服务还要检查政策是否仍有效、用户是否有订单访问权限,以及必要时由人工审核最终发出的高风险承诺。
实现时可以把流程写成以下伪代码。draft 指当前草稿,feedback 指检查结果,max_revisions 指最多改写次数,source_bundle 指已经按身份权限取得并标明版本的订单与政策材料;generate_reply 负责初稿,check_reply 逐项返回依据和问题,revise_reply 只针对问题修订。函数名是示意,不对应某个框架的现成接口。
text
draft = generate_reply(user_question, source_bundle)

for revision_no in 0..max_revisions:
    feedback = check_reply(draft, source_bundle, criteria)
    if feedback.evidence_missing:
        return "暂停自动答复,补查政策或转人工"
    if feedback.passed:
        return draft
    if revision_no == max_revisions:
        return "停止自动修订,转人工复核"
    draft = revise_reply(draft, feedback, user_question, source_bundle)
这里 criteria 是前面三条检查项目;revision_no=0 表示检查初稿;假设 max_revisions=2,系统最多在初稿之后再改两次。check_reply 返回的不只是“通过/失败”,还应有哪句话失败、与哪条证据冲突。否则修订者不知道改哪里。生产系统应限制每轮耗时与调用费用,并记录草稿版本、检查标准版本、证据版本、反馈和最终去向,便于事后定位错误;不应在日志里无控制地保存用户敏感信息。
什么样的反馈才有用
“表达清楚、很有同理心,继续保持”是语气评价。它没有回答是否能退款,也没有找出政策与文本的矛盾。更糟的是,如果生成者和检查者都只看到同一段过时摘要,它们可能一致认可一个错误。反射的有效性取决于检查能否发现生成步骤没发现的东西。
可把检查信息分成三层:
- 确定性检查:程序检查禁用承诺词、必填字段、金额计算、订单归属与是否存在真实申请记录。能用代码断言的地方优先用代码,不能让模型的“我认为已通过”替代运行结果。
- 证据对照:给检查者当前有效的政策原文、版本和具体订单字段,要求每个关键结论有对应依据。证据缺失或版本冲突时,不应靠多轮重写填空。
- 语言与体验检查:再看回答是否清楚、礼貌、切题。此项适合模型评价,但不能覆盖前两层的事实错误。
例如生成代码时,单元测试的失败断言比“代码看起来正确”更有力;写研究摘要时,原文中的数值和限定条件比自评“摘要准确”更有力。Reflexion 论文研究的是 Agent 利用环境反馈,并把文字反思保存在记忆中指导后续尝试;它与这里的单份客服草稿修订有相似的“利用反馈”思想,但不是完全同一个实现,也不是更新模型权重的强化学习训练。
什么时候停,什么时候不适合加反射
反射每多一轮通常多出模型调用、等待时间和费用;更长的对话还可能让修订者改坏原本正确的句子。Anthropic 的工程经验也把这种流程限定在评价标准清楚、迭代确实有可衡量收益的任务上。来源
| 情况 | 合理动作 | 原因 |
|---|---|---|
v1 经政策与订单记录检查通过 | 停止并发送 | 继续改写会增加成本,也可能引入新错误。 |
| 两轮修订后仍反复写“保证退款” | 停止自动发送,转人工并留存失败记录 | 重复同样提示不保证下一轮突然正确。 |
P2 缺失、失效或两份政策冲突 | 暂停并补查,必要时转人工 | 评价依据不可靠时,检查者无法给出可信结论。 |
| 用户只问已知、可直接查询的订单状态 | 直接查订单并按模板答复 | 有确定答案时,额外生成—评价循环可能只增加延迟。 |
| 要执行真正的退款 | 走权限校验、业务规则与审批工具 | 文本反射不能代替授权或具有副作用的业务流程。 |
失败还有一种隐蔽形式:检查者被初稿的流畅话术带偏,只反馈“语气很好”。可在测试集中放入“已完成未执行操作”“条件偷换”“引用过期版本”等故意设计的错误,看检查者能否定位并拒绝;线上再看错误承诺率、人工改写率、平均调用次数与延迟。若检查者不能稳定发现目标错误,先改证据和评价标准,再考虑加轮数。评估时也要看修订稿是否把正确内容改错,不能只统计“检查者给了通过”。
面试时怎么回答
反射模式是让系统先产出候选结果,再按明确标准检查,给出能定位到问题和依据的反馈,最后针对反馈修订,并在通过或达到预算时停止。比如客服助手起草“30 天内可直接退款”,检查步骤拿当前售后政策和订单记录核对,发现政策只允许申请检测、也没有真实退款申请,就要求删掉错误承诺并重写。检查可以由同一模型的另一轮调用、专门评估模型、规则或人工完成,但模型自评不等于事实验证;涉及事实与动作时要依赖政策、工具结果和测试。我会设最大修订次数、耗时与费用预算,证据缺失或反复失败就停下转人工,并用错误承诺率和人工改写率判断这套循环是否值得保留。
如果面试官追问“反射是不是一定要两个模型”,答案是不一定:Self-Refine 就用同一模型扮演不同角色;真正要区分的是生成步骤和检查步骤是否有明确的评价目标、能否得到独立于草稿的事实依据。若追问“多反射几轮是否一定更好”,答案也是不一定:检查者可漏检,修订者可引入新错误;用固定测试集和线上指标比较不同轮数,达到收益不再覆盖成本时就停止。
资料依据
- Self-Refine: Iterative Refinement with Self-Feedback:同一模型提供反馈并迭代修订的原始研究。
- Reflexion: Language Agents with Verbal Reinforcement Learning:环境反馈、文字反思与后续尝试的原始研究,用于区分具体 Reflexion 方法与通用反射流程。
- Anthropic, Building effective agents:生成者—评估者流程的适用条件与 Agent 运行时停止条件。