Appearance
Q21 · 在 AI 智能体项目中,你如何解决 Agent Loop 可能出现的死循环问题?
用户问客服:“订单 A123 的耳机能退吗?”智能体可以先查订单,再查适用的退货政策,最后给出有证据的答复。麻烦在于,它也可能查不到政策后一直执行同一句查询:“再查一次耳机政策”,每次都收到“未找到”,却始终不结束。用户只看到转圈,后台却不断消耗模型调用、工具请求和时间。
解决办法要落在运行智能体的程序上:明确什么算完成,记录每轮新增的事实,发现重复且没有进展时停下;再设置绝对步数、时间和成本上限;将无法解决的请求交给人或请用户补充信息。仅在提示词里写“不要死循环”,并不能保证程序真的停止。LangChain 的官方文档把 Agent 描述为“模型循环调用工具,直到任务完成”,LangGraph 则专门对达到最大步骤而未满足停止条件的情况报告 GRAPH_RECURSION_LIMIT。LangChain Agents · LangGraph 循环上限错误
先认清循环里的术语、工具和状态
| 术语或记号 | 本文含义 | A123 例子 |
|---|---|---|
| Agent Loop(智能体循环) | 程序反复让模型选择下一步、执行工具、读取结果,再决定是否继续的过程 | 查订单 → 看结果 → 查政策 → 看结果 → 回答 |
| LLM / 模型 | 根据当前可见信息提出回答或工具调用的组件 | 提出“调用 get_policy” |
| Tool(工具) | 程序提供的外部能力;模型提出调用,程序校验后执行 | get_order 查订单,get_policy 查政策 |
| Observation(观察) | 工具返回的事实、空结果或错误 | get_policy 返回“未找到” |
| State(状态) | 本次请求已确认的事实、待解决问题、计数器和执行记录 | 已知商品为耳机,尚无有效政策 |
| 进展 | 得到了新的可核验事实,或明确缩小了待解决问题 | 查到有效政策及其生效日期 |
| 重复状态 | 相同工具和规范化参数再次产生相同结果,已确认事实也没有变化 | 两次用相同条件查政策,均“未找到” |
| 终止原因 | 程序记录的结束类别 | completed、no_progress、budget_exhausted |
| 硬预算 | 程序强制执行的步数、时间、用量上限 | 最多 6 次模型决策、4 次工具调用、30 秒 |
| 幂等 | 同一业务写入即使重复执行,也只产生一次业务效果 | 重试退款申请不能生成两张申请单 |
这里的 get_order 和 get_policy 是讲解用的只读示例接口,不是某个框架自带的命令。A123 是虚构订单。下文假设用户已通过身份核验,订单显示“耳机、已签收 3 天、未拆封”;政策库若正常返回,则有一条当前有效的“签收 7 天内且未拆封,可提交人工退款审批”规则。即便两项都符合,智能体也只能说“初步符合提交审批条件”,不能宣布退款已经批准。
正常循环怎样结束,死循环又怎样形成
一个正常轨迹可以逐轮检查:
| 轮次 | 模型提出的下一步 | 工具观察或程序结果 | 状态里的变化 |
|---|---|---|---|
| 1 | 查 A123 | 商品为耳机,签收 3 天,未拆封 | 新增已核验订单事实 |
| 2 | 按“耳机”和当前日期查政策 | 返回有效的 7 天规则 | 新增适用政策与生效日期 |
| 3 | 给用户初步答复 | 程序检查回答引用了订单与政策 | 任务完成,停止循环 |
失败轨迹只改一个条件:政策工具因索引缺失,每次都返回“未找到”。
| 轮次 | 模型提出的下一步 | 观察 | 应用应该怎样处理 |
|---|---|---|---|
| 1 | 查 A123 | 得到订单事实 | 继续 |
| 2 | get_policy(耳机, 当前日期) | 未找到 | 允许有限的替代查询,例如检查分类映射 |
| 3 | 同参数再次调用 get_policy | 仍是未找到 | 判断本轮没有新增事实,重复签名累计到 2;停止重复查询 |
| 结束 | 不再让模型无限“再试一次” | 记录 no_progress | 告知用户政策暂无法核实,并转人工核对 |
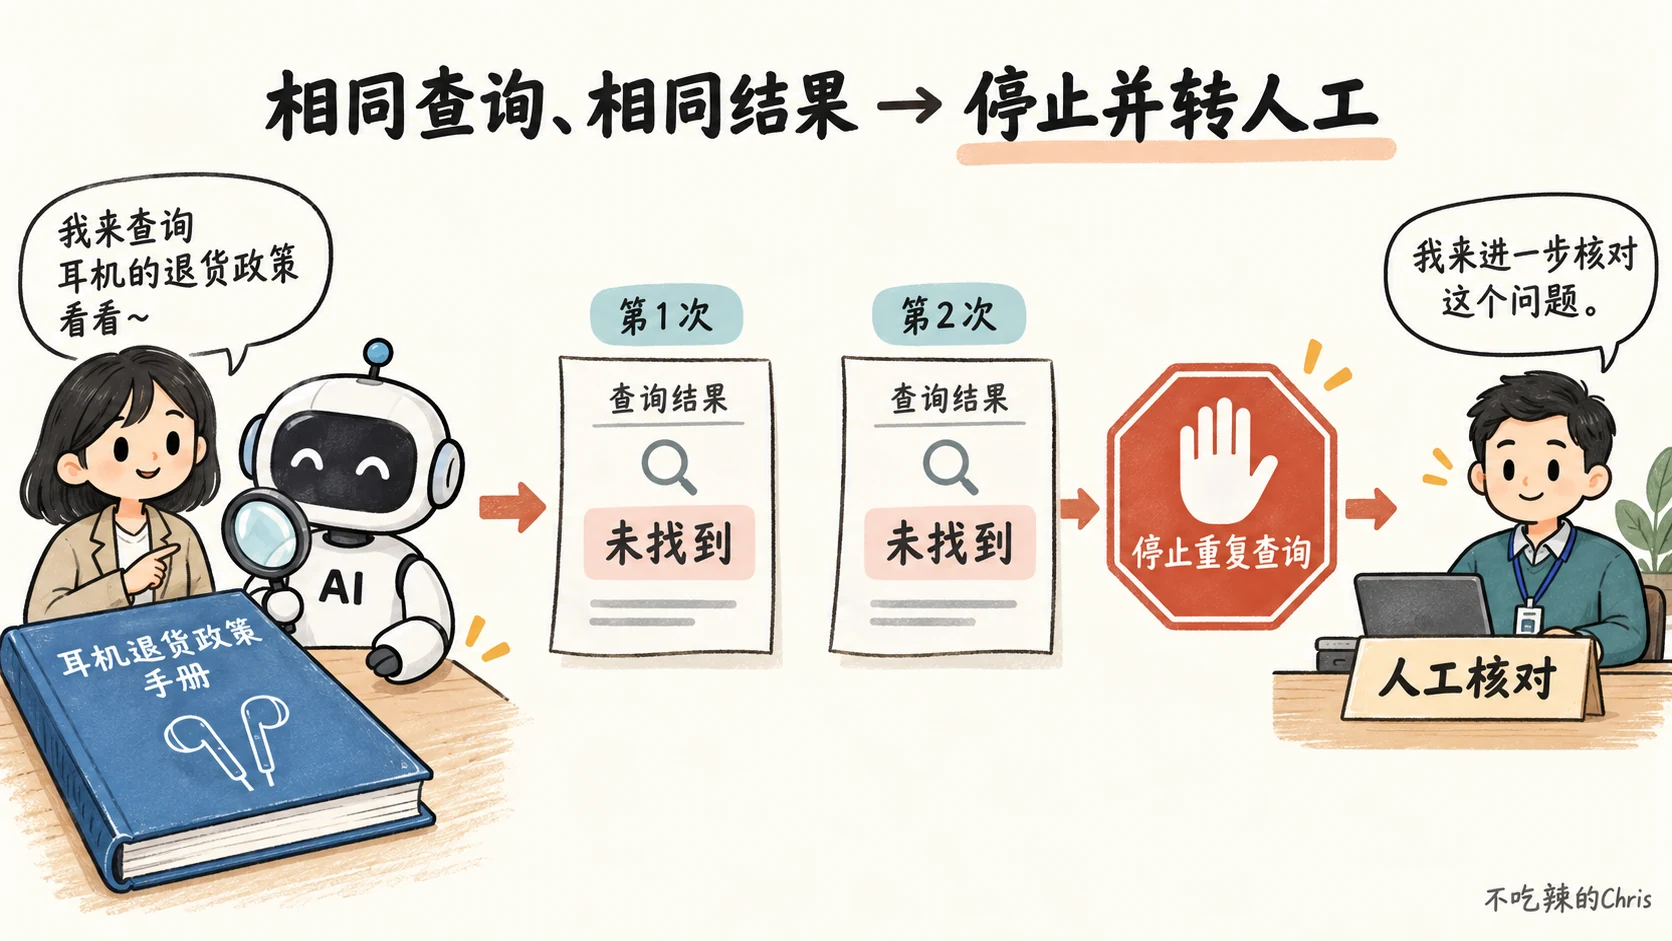
图中的两张“未找到”回执对应上表第 2、3 轮:相同查询和相同结果已经被观察到,程序不再把“再试一次”当成进展。转人工时要把订单事实、已尝试的查询条件和错误状态一并交过去,避免人工从头重查。图示只覆盖“重复且无进展”这条路径;一次暂时性网络超时能否重试,要按错误类型另行决定。
死循环并不只有“同一句话重复”一种形状。常见原因还有:工具返回的“未找到”被模型误当成“再查就会找到”;A、B 两个工具互相把任务推回去;解析工具输出失败后模型反复改写相同请求;任务本来就缺少必要信息,却没有“向用户追问或转人工”的出口;图中的路由边甚至可能被代码接成 A → B → A。最后一种情况,LangGraph 官方建议先检查是否真有循环,再判断是否只是复杂任务需要更高的步数限制,不能见到上限错误就一味调大 recursion_limit。LangGraph 循环上限错误
用四层控制把循环关住
第一层:定义可验证的完成与退出。 用户要的是“能否提交退款审批”,因此至少要有经过权限校验的订单事实、当前适用政策,以及两者之间的条件比较。模型说“完成了”只是一个候选结果;应用还要检查证据是否齐全。政策缺失时,不能凭常识编一条,也不能永远继续查:可追问用户补充商品信息,或转人工核对。若用户撤销任务、工具返回明确的权限拒绝,也应结束本次循环并给出相应状态。Anthropic 的智能体设计指南也强调给 Agent 设置明确的停止条件,例如最大迭代次数,并在需要时暂停交给人处理。Building Effective AI Agents
第二层:识别“重复但无进展”。 每次工具调用后,把工具名、排序并规范化的参数、结果状态与结果摘要组成一次“调用签名”。同一签名出现两次且已核验事实没有变化,就触发 no_progress。别只比较原始文本:工具可能每次附带不同时间戳,但实质仍是“未找到”;也别只比较工具名:查询日期或商品类别变了,就可能是真正的新尝试。对于 A123,这一层能比等待 30 秒超时更早发现问题。
第三层:硬预算兜底。 在应用侧设置模型决策次数、工具调用次数、每类工具重试次数、墙钟时间,以及能获得时的 token/费用预算。6/4/30 秒 只是本文示例配置,应按任务复杂度和业务延迟目标调整。预算要在每轮调用前检查,并给单次模型输出与工具请求设置超时;否则单次挂起也能绕过“最多六轮”。预算耗尽时写明 budget_exhausted,把当前事实与未解决的问题带到安全出口。框架自己的步数限制可作为兜底,但业务上的“缺政策转人工”仍需自己设计。LangGraph 循环上限错误
第四层:工具执行边界。 读工具遇到网络超时,可按错误码做少量退避重试;对“成功返回空结果”重复同参数查询,通常不会因重试而变出新事实。写工具风险更大:若智能体提交退款申请后响应丢失,再次提交可能生成重复申请。应用应先校验身份与权限,再使用稳定的业务幂等键或唯一约束,查询上一次提交结果;错误类型不明时交由人工核实,不能盲目重放写操作。无论模型给出多少次工具请求,执行权都在应用层。
这些层次各管不同问题:重复检测快速发现无进展,硬预算防止漏网循环,业务出口让用户得到明确结果,工具边界防止“停止之前”已经产生重复副作用。提示词可以告诉模型何时考虑结束或求助,但这些规则最终都要由程序检查。
一段能落地的控制伪代码
先说明伪代码中的名字:state 保存已核验事实和待解决问题;model_turns、tool_calls 是本次请求已发生的调用次数;deadline 是截止时间;usage 是已上报的模型用量;repeat_count 记录某种调用与结果组合出现了几次。choose_next(state) 让模型返回三类可见决定之一:final(建议答复)、ask_user(需要用户补信息)、tool_call(建议调用工具)。execute_checked 是应用的权限与参数校验后才会执行的工具包装器。下面是与框架无关的伪代码,数字仅用于说明控制点:
text
MAX_MODEL_TURNS = 6
MAX_TOOL_CALLS = 4
MAX_SECONDS = 30
MAX_REPEATS = 2

state = {verified_facts: {}, open_questions: ["A123 能否提交退款审批?"]}
model_turns = 0
tool_calls = 0
repeat_count = {}
deadline = now() + MAX_SECONDS

while true:
    if now() >= deadline or model_turns >= MAX_MODEL_TURNS:
        return handoff("budget_exhausted", state)

    decision, usage = choose_next(state, timeout=remaining(deadline))
    model_turns += 1
    record_usage(usage)

    if decision.kind == "final":
        if has_required_evidence(state, decision.answer):
            return finish("completed", decision.answer)
        return handoff("missing_evidence", state)

    if decision.kind == "ask_user":
        return ask_user_and_pause(decision.question, state)

    if decision.kind != "tool_call" or tool_calls >= MAX_TOOL_CALLS:
        return handoff("invalid_action_or_budget", state)

    validate_permission_and_args(decision.tool, decision.args)
    result = execute_checked(decision.tool, decision.args,
                             timeout=remaining(deadline))
    tool_calls += 1

    if result.is_transient_error:
        # 将错误写入状态,下一轮允许模型改策略;同工具最多重试一次
        append_error(state, result)
        if retry_quota_left(decision.tool):
            consume_retry_quota(decision.tool)
            continue
        return handoff("tool_error", state)

    old_facts = state.verified_facts.copy()
    merge_verified_facts(state, result)
    signature = fingerprint(decision.tool, canonical(decision.args),
                            semantic_status(result), stable_digest(result))
    repeat_count[signature] = repeat_count.get(signature, 0) + 1

    if state.verified_facts == old_facts and repeat_count[signature] >= MAX_REPEATS:
        return handoff("no_progress", state)

    append_observation(state, result)
沿 A123 的失败轨迹走一遍:第一次政策查询返回“未找到”,签名计数为 1;模型若用完全相同的条件再查,结果还是“未找到”,签名计数为 2,verified_facts 仍无新增政策,于是返回 no_progress。如果第二次查询改为有效的商品分类并查到了政策,其签名不同,而且新增了政策事实,循环可以继续。fingerprint 与“事实是否变化”的判断需要按业务定义;真实系统还要把工具重试、模型 token 用量和并发取消纳入预算。伪代码的 continue 只允许在该工具的有限重试额度内执行;每次重试都重新经过总步数与时间检查,不能成为无限重试许可证。
线上怎样发现和复盘循环
每个请求保留可追踪的运行记录:请求 ID、各轮工具名、脱敏后的参数摘要、结果状态、是否新增事实、连续无进展次数、模型和工具调用次数、耗时、用量、最终终止原因。关注 no_progress 与 budget_exhausted 比例、相同工具的重复调用、超时与人工接管量;突增时能定位是政策索引故障、工具格式变化,还是模型决策退化。客户姓名、完整订单内容与密钥不应直接放进普通监控日志。
上线前把上述“正常找到政策”“连续空结果”“瞬时超时后恢复”“写工具响应丢失”“权限拒绝”等轨迹做成回归用例,检查最终状态、调用次数和是否有重复业务写入。线上监控告诉我们正在发生什么;离线评测则拿固定用例验证改动会不会再触发相同问题。LangSmith 官方文档把生产期在线评估用于监控异常、离线评估用于发布前的基准和回归检查,两者可共同形成反馈闭环。LangSmith Evaluation types · LangSmith Dashboards
面试时可以这样回答
Agent Loop 是模型根据工具观察反复选择下一步的执行循环。解决死循环不能只靠提示词,我会在应用层做四件事:先定义“证据齐全才能完成”和缺信息时的追问、转人工出口;再记录工具名、规范化参数、结果和已核验事实,连续相同且无新增事实就停止;同时设置模型轮数、工具调用数、单次超时、总时长与成本等硬预算;最后区分暂时性错误和空结果,限制重试,对写工具加权限校验和幂等保护。线上记录每轮轨迹与
no_progress、budget_exhausted等终止原因,拿真实失败轨迹做回归评测。比如查耳机退货政策两次都返回相同的“未找到”,我会停止重复查询,说明政策暂无法核实并转人工,而不是让模型一直重试或编造结论。
参考资料
- LangChain:Agents —— 模型与工具循环的定义。
- LangGraph:GRAPH_RECURSION_LIMIT —— 达到步数上限的错误与排查方向。
- Anthropic:Building Effective AI Agents —— 停止条件与人工参与。
- LangSmith:Evaluation types —— 在线监控与离线回归评测的区别。
- LangSmith:Monitor projects with dashboards —— 运行指标与仪表板。