Appearance
Q126 · L1 和 L2 正则化分别是什么,什么场景适合使用呢?
假设一家小店用历史记录预测下周销量。模型不仅看促销折扣,还看海报的颜色编号。在收集到的几十条记录里,红色海报碰巧常出现在畅销周;模型于是给“红色”很大的影响。它在这些旧记录上答得很好,换一批新记录却不准:它把偶然相关当成了可重复的规律。这就是过拟合的一种表现——训练数据上的误差小,未参与训练的数据上的误差却大。
正则化是在训练模型时,除了追求“拟合旧数据”,还对模型过大的参数收费,使模型更谨慎地依赖某些特征。L1 对参数的绝对值收费,L2 对参数的平方收费。二者都会限制参数,但 L1 容易得到恰好为零的参数,L2 通常把多个参数一起缩小。scikit-learn 线性模型文档分别用 Lasso 和 Ridge 展示了这两类惩罚的目标函数与系数行为。
术语与符号
| 术语或符号 | 直白解释 | 小店例子 |
|---|---|---|
| 样本 | 一条用于学习或检查的数据记录 | 某周折扣、海报颜色和实际销量 |
| 特征 | 用于预测的输入信息 | 折扣、海报颜色编码 |
| 标签 | 想预测的实际结果 | 该周实际销量 |
| 模型参数 / 权重 | 决定某项特征对预测值影响大小的数 | 折扣对应的系数和颜色对应的系数 |
| 训练集 | 用来拟合参数的记录 | 旧周次的销量数据 |
| 验证集 | 不参与本次拟合,用来比较方案和选参数的记录 | 另一批留出的周次 |
| 损失函数 | 用数字衡量预测错多少的规则,越小表示按该规则错得越少 | 预测销量与真实销量之间的平方误差 |
| 正则化 / 惩罚项 | 在损失之外,为复杂或过大的权重增加代价 | 让模型不轻易把颜色碰巧相关当成强规律 |
| λ(lambda) | 本文用来表示惩罚强度的非负数;具体库可能叫 alpha、C 等,定义也可能不同 | λ 越大,一般越不愿让权重变大 |
| w₁、w₂ | 两个待学习的权重;本文的数字例子假设特征已同尺度 | w₁ 对应折扣,w₂ 对应海报颜色 |
| 稀疏 | 一组权重里有些恰好等于零 | w₂ = 0 时,预测式暂时不用颜色 |
| 缩放 / 标准化 | 把输入特征调整到可比较的数值尺度 | 不让“折扣 0~1”和“销售额几万元”的单位差异影响惩罚 |
| 优化器 | 根据目标函数调整权重的计算方法 | 寻找让损失加惩罚最小的 w₁、w₂ |
“权重等于零”只表示这个训练结果没有使用该特征,不能据此断言该特征在现实中绝对无用。记号“|w|”表示绝对值,负数也按离零的距离计算;“w²”表示平方。本文用 λ 统一说明原理,不等于任何库里相同数值的参数可以直接互换。
从“拟合数据”变成“拟合数据并限制权重”
先看最简单的线性预测:把每个特征乘上一个权重,再把结果相加,得到预测销量。如果 w₁、w₂ 的绝对值很大,输入稍微变动,预测就可能大幅跳动;对训练集里的噪声,模型也更容易给出夸张的解释。但“大权重就一定过拟合”并不成立,判断仍要看留出数据表现和业务含义。
没有正则化时,训练只想最小化“预测误差”。有正则化时,训练目标变成:
总目标 = 预测误差 + λ × 权重惩罚。
这里的“+”不是把预测值相加,而是把模型训练时要尽量压低的两项代价相加。λ = 0 时没有这项额外收费;λ 增大时,同样大小的权重会付出更高代价。过大的 λ 又会把有用信号也压掉,造成欠拟合:训练集和验证集都表现差。因此 λ 应由合适的验证方法选择,而不是盲目取最大。scikit-learn 的 Ridge 文档说明其强度参数控制系数收缩;Lasso 文档同样把强度参数乘在 L1 项上。
对于两个权重,L1 惩罚是 |w₁| + |w₂|,L2 惩罚通常写作 w₁² + w₂²。有些资料把 L2 范数写为“平方和再开根号”;回归中常说的 L2 正则化惩罚一般是平方和,有时还带 1/2 这样的常数。常数可以并入强度参数,但比较不同论文或软件时必须看清其实际目标函数。scikit-learn 的 Ridge 目标函数是平方残差和加 alpha 乘以权重平方和,Lasso 则采用按样本数归一后的平方误差加 alpha 乘以绝对值和,因此两者的 alpha 数字不能直接当成同样强度。Ridge 文档 · Lasso 文档
同一组数字,看出 L1 和 L2 怎样改变权重
下面是可手算的教学模型,不是声称用真实销量训练得出的结果。假设两个输入特征已缩放到可比较的尺度,且数据关系恰好能分离成两个权重的平方误差:
预测误差 = (w₁ − 3)² + (w₂ − 0.5)²。
这句话的含义是:只顾训练数据、不做惩罚时,最优权重是 w₁ = 3、w₂ = 0.5。把 w₁ 想成折扣信号、w₂ 想成海报颜色信号;后者在训练集里有一点相关,但我们尚不知道它能否在新数据中成立。为了看清两种惩罚的形状,分别设教学用 λ = 1;同一个数值不代表 L1 与 L2 的惩罚程度在现实中一样强。
加 L1 后,训练要最小化:
(w₁ − 3)² + (w₂ − 0.5)² + |w₁| + |w₂|。
这组数的最优解是 w₁ = 2.5、w₂ = 0。以 w₂ 为例:若还取 0.5,它不付预测误差,却付 0.5 的惩罚;若取 0,预测误差增加 0.25,惩罚省下 0.5,总目标反而更低。更精确地说,在 w₂ = 0 附近,绝对值惩罚形成一个“尖点”,足以把这个较弱权重停在零。对 w₁,折扣信号在教学目标中较强,留下它比完全抹去更划算,但它也从 3 缩到 2.5。
加 L2 后,训练要最小化:
(w₁ − 3)² + (w₂ − 0.5)² + w₁² + w₂²。
把每个权重的“偏离原目标的代价”和“权重本身的平方代价”一起平衡,最优解是 w₁ = 1.5、w₂ = 0.25。它们都变小,w₂ 却没有被压成零。可以只验 w₂:取 0.25 时两项代价分别是 0.25² 和 0.25²,总共 0.125;取 0 时第一项是 0.5² = 0.25,反而更大。
| 教学设置 | w₁:折扣系数 | w₂:颜色系数 | 从结果能看出什么 |
|---|---|---|---|
| 不加惩罚 | 3 | 0.5 | 只看教学训练误差的最优点 |
| L1,λ = 1 | 2.5 | 0 | 较小的系数在本例恰好变零 |
| L2,λ = 1 | 1.5 | 0.25 | 两个系数在本例都缩小 |
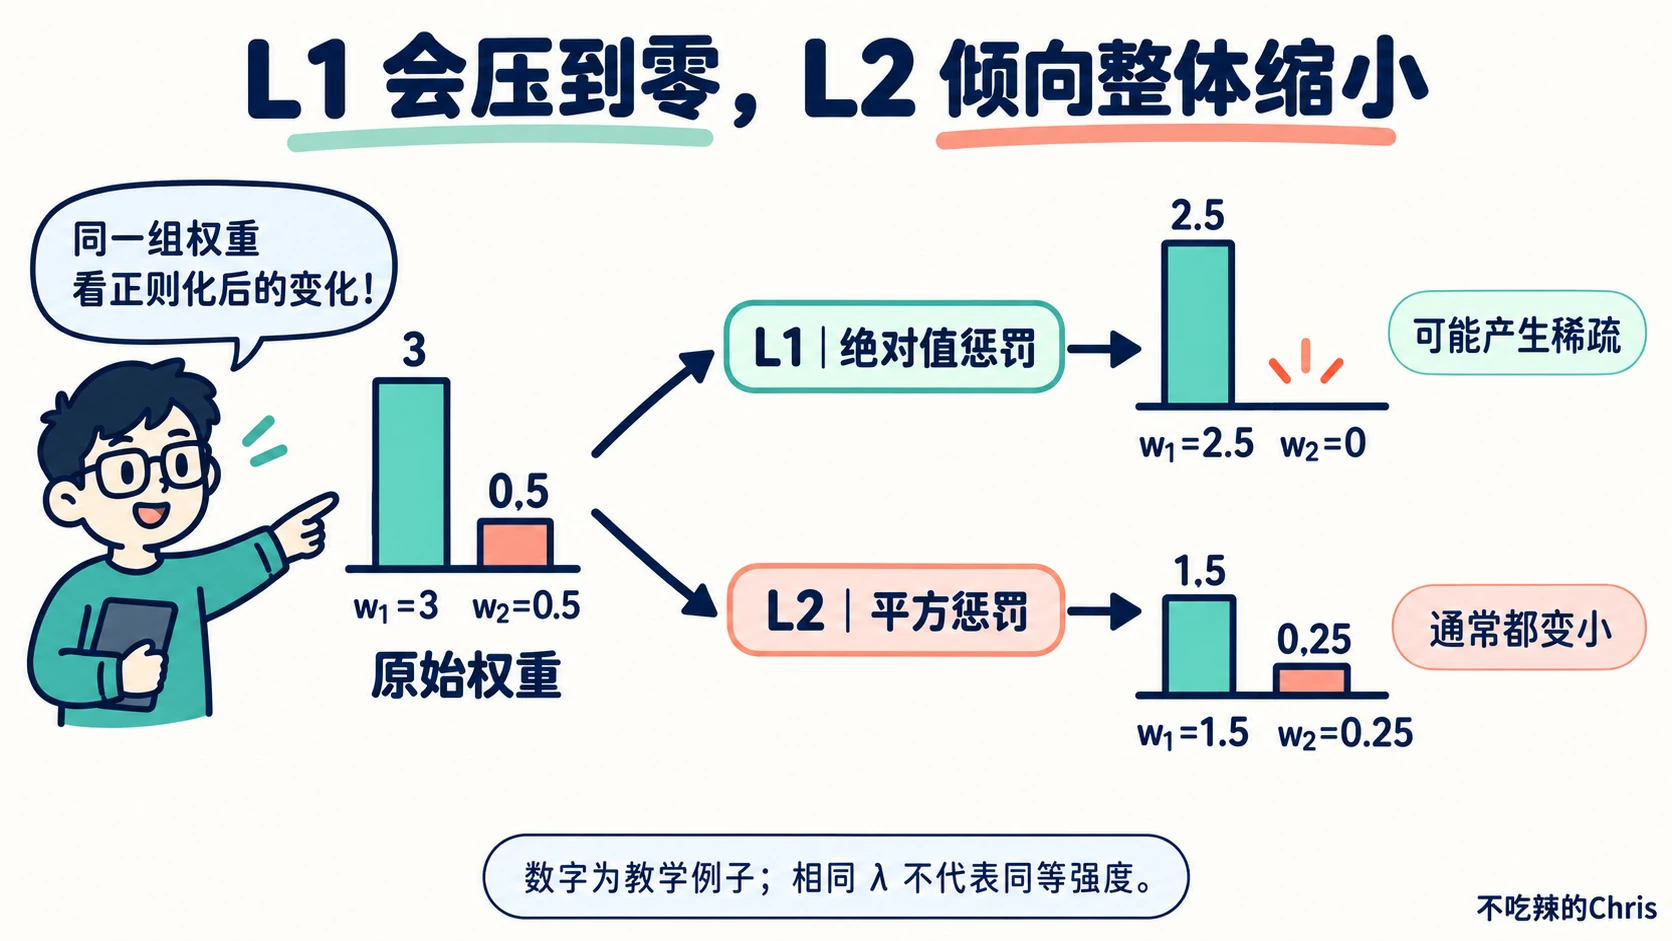
图中的横向分叉是两次不同训练方案的比较,不是先对权重做 L1、再对结果做 L2。图上“L2 倾向整体缩小”说的是常见行为;特殊数据或约束下,L2 的某个系数也可能正好为零。
为什么 L1 容易产生零,L2 通常保留非零
从图形和优化角度看,绝对值函数在零处有尖点;离零很近时,不论向正还是向负挪一点,都要付出一阶的额外代价。若降低预测误差的收益不够大,最优选择就停在零。Lasso(带 L1 惩罚的线性回归)的官方文档明确说明它能估计稀疏系数,并在坐标下降求解中展示了把小值截成零的“软阈值”运算。scikit-learn:Lasso 与坐标下降
平方函数在零处是光滑的,且接近零时额外惩罚逐渐变小。它会持续拉小权重,但通常不会制造一批恰好为零的系数。Ridge(带 L2 惩罚的线性回归)常用于想压制过大的系数、却不希望轻易丢掉输入信息的情况,尤其多个特征高度相关时可改善系数的稳定性。scikit-learn:Ridge
实现上也有差别:L2 平方惩罚的导数是平滑的,便于许多基于梯度的优化方法处理;L1 绝对值在零点不可按普通方式求唯一导数,常使用能处理这个尖点的算法,例如坐标下降或近端方法。不可导不等于无法优化。本题数值例子的最优值已直接给出,真实训练中优化器才需要反复更新权重;不同求解器、收敛容差和约束也会影响最后显示的零是否足够精确。scikit-learn 的 Lasso 实现说明
场景选择:看目标,也看数据关系
如果你想得到较少的非零特征,且业务允许某些输入完全不进入模型,可以尝试 L1。它常被用于特征选择或建立容易查看的稀疏线性模型。但“w₂ = 0”不等于“海报颜色在世界上没用”:训练样本少、噪声大或多个特征彼此相关时,L1 可能不稳定地挑中其中一个,漏掉另一个有用特征。scikit-learn 对 Elastic Net 的说明就指出,高相关特征下 Lasso 可能任意选择其中一个,混合 L1/L2 的 Elastic Net 更可能保留一组相关特征。scikit-learn:Elastic Net
如果多数特征可能都含少量有效信息,或特征之间相关性高、你更希望权重平稳缩小,可先试 L2。它往往保留更多非零项,但“保留”不是保证预测更好,也不是说每个小系数都有独立因果解释。对于混合需求,可试 L1 与 L2 的组合;选择要由验证集指标、系数稳定性与业务约束共同决定。scikit-learn:Ridge、Lasso 和 Elastic Net
实际比较时,应先定好相同的训练/验证划分和主要评价指标,再分别为 L1、L2 搜索合适的强度。不能只比较“哪个训练误差小”;正则化可能让训练误差稍大,却让新样本误差下降。若是按时间预测销量,应让较早周次训练、较晚周次验证,避免把未来信息泄漏进过去。之后还要检查:海报颜色在不同验证切分里是否反复入选?折扣权重是否稳定?对不同客户或季节是否失效?这些检查比只看一次“稀疏率”更可靠。
特征尺度不统一,会把选择问题带偏
想象同一“折扣”既可写成 0.2,也可写成 20%。为了表示同样的预测影响,配套权重会相差 100 倍。L1 和 L2 都直接惩罚权重数值;如果不先处理输入单位,就可能对某些特征“罚得更重”,对另一些“罚得更轻”,导致系数大小和选特征结果受计量单位影响。这就是为何在线性模型使用正则化前,常要合理标准化或按业务含义统一量纲。scikit-learn:数据预处理
标准化要只用训练集估计转换所需的均值、标准差等统计量,再把同一转换应用到验证集与未来数据;先用全量数据算缩放参数会把验证集信息带进训练过程。某些输入(例如稀疏矩阵)不适合直接做会破坏稀疏结构的中心化,具体转换仍要依数据类型选择。scikit-learn:Common pitfalls / Data leakage · scikit-learn:StandardScaler
另一个常被忽略的细节是截距:它代表所有特征取参考值时的基线销量,与各特征权重不同;很多常见线性模型的惩罚目标只写特征权重,不同实现对截距是否受罚的处理可能不同。读库文档时应确认这一点,不要把“所有参数一律被惩罚”当作普遍事实。scikit-learn:线性模型与截距
L2 正则化、weight decay 与 AdamW 的边界
训练神经网络时会听到 weight decay(权重衰减):每步更新时,额外把权重往零方向拉一点。在普通梯度下降、相同学习率且目标定义匹配的理想条件下,把 L2 平方惩罚加进损失后求梯度,可以写成与权重衰减相对应的更新式,所以教材常把两者联系起来。但系数里的 2、是否按样本数平均、参数组是否排除某些权重,都要按实现定义换算,不能简单说参数值完全相同。
到了 Adam 这类自适应优化器,情况变了:Adam 会根据历史梯度调整每个参数的步长。如果把 L2 惩罚的梯度直接加进任务梯度,它也会进入 Adam 的历史统计;这与“独立于梯度统计地缩小权重”的更新不一样。AdamW 采用后者,即解耦的 weight decay。它仍是一种限制权重的训练选择,但不能简单说“AdamW 的 weight_decay 参数就是在损失上加 λ∑w²,且效果完全相同”。这一差别来自 Loshchilov 与 Hutter 的原论文;PyTorch 的 AdamW 文档也明确说明衰减不会积累到动量和方差统计里。
这里不需要把神经网络优化器和前面的 Lasso/Ridge 数值例子混为一谈:前者解释每一步怎样更新参数,后者先解释目标函数怎样偏好某组系数。不同模型、优化器、参数分组下,正则化效果要重新验证。
什么时候会失败,以及怎样发现
λ 太小。 在小店例子里,颜色碰巧相关仍可能被模型重度依赖;训练误差很小,未来周次误差偏大。可以在多段较晚周次上验证,并检查颜色系数是否随训练时间大幅变动。
λ 太大。 折扣确实影响销量,却也被压到接近零;训练和验证都预测得差。应降低强度或修正模型,而不是只因参数“很小”就觉得模型稳健。
L1 挑错特征。 假设颜色编号和某个真实影响销量的陈列位置高度相关,L1 可能只留颜色、丢掉位置;换店后颜色规则改变,预测崩溃。应检查相关特征、跨时间和跨门店的稳定性,必要时保留成组特征或试 Elastic Net。L1 的稀疏是数学结果,不是因果证明。
不做缩放或发生数据泄漏。 同一折扣换成百分数后系数选择明显变化,或离线验证很好、线上突然很差。检查训练与预测的特征处理是否一致,缩放统计量是否只从训练数据学得。
面试里怎样回答
“L1 和 L2 都是在原本的预测损失之外对权重加惩罚,用来限制模型过度贴合训练样本。L1 惩罚权重绝对值之和,零点有尖点,所以容易产生恰好为零的系数,适合想要稀疏模型或尝试特征选择时。L2 惩罚权重平方和,通常让多个系数平滑收缩,适合多数特征可能都有信息、或特征相关时先求稳定的情况。强度要用验证集选;先注意特征缩放和数据泄漏。L1 不保证挑到真正有用的特征;而在 Adam 这样的优化器里,直接加 L2 梯度与 AdamW 的解耦 weight decay 也不等价。”
如果面试官追问“L2 是否绝对不产生零”,可答“通常不产生 L1 那样的稀疏效果,但特殊数据或约束下某个系数仍可能正好是零”。如果追问“为什么不能照抄 λ”,可答“损失是否求平均、惩罚项是否带常数、特征尺度与库的参数定义不同;即便教学例子里都写 λ = 1,也不是同等强度”。
资料依据
- scikit-learn:Linear Models:Ridge、Lasso、Elastic Net 的目标函数、稀疏与相关特征边界。
- scikit-learn:Preprocessing data 与 Common pitfalls:特征尺度与训练/验证数据泄漏。
- Loshchilov 与 Hutter,Decoupled Weight Decay Regularization 与 PyTorch:AdamW:L2 梯度惩罚与解耦 weight decay 的边界。